刷屏快一周的匿名模型「牛來」,正式揭曉了真身。
8 月 26 日晚,智譜正式上線並開源了 GLM-5.3 Flash,確認它就是 8 月 20 日起以 Ox-Alpha 代號,在大模型聚合平台 OpenRouter 和 OpenCode 上匿名測試的那個模型。
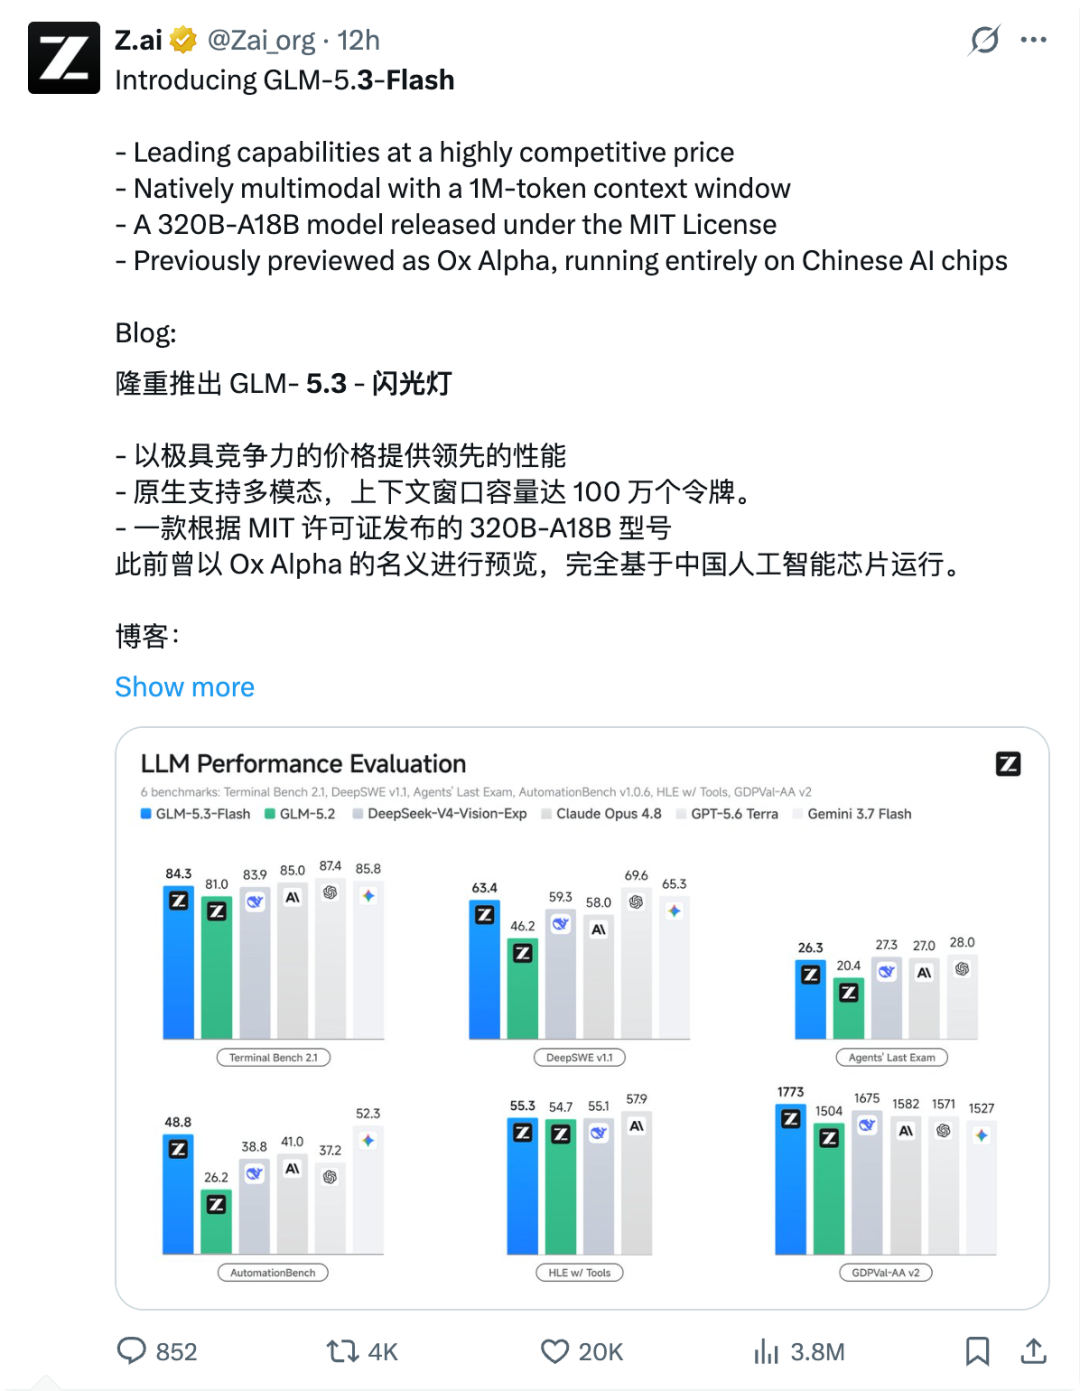
說起來,這是智譜第二次用這種匿名模型先免費跑一周賺流量,然後再官宣認領,上次是「馬來」。春節前夕的 Pony-Alpha,後來被證明是 GLM-5。
就在同一晚,阿里也發布了一款新模型,且一樣是 Flash 款。Qwen3.8-Flash 正式在大模型開源平台 Hugging Face,和阿里的模型開源社區魔搭 ModelScope 開源權重。
特別的是,千問這款新模型,雖然是 Flash,但是卻作為 Qwen4 架構的早期預覽版,用的是下一代 Qwen4 模型的新架構。
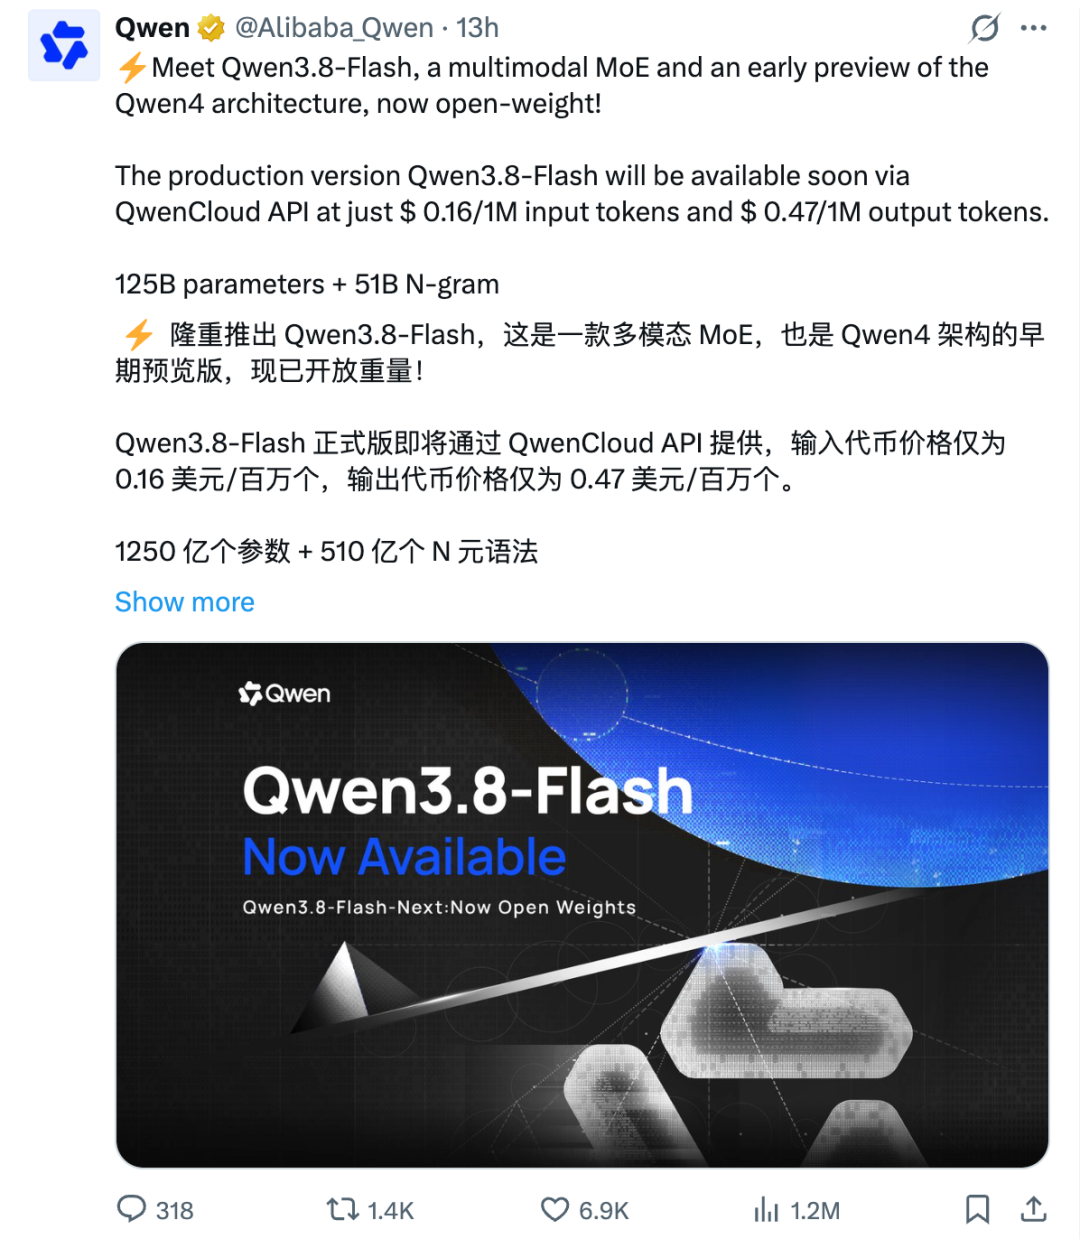
架構之外,兩個新模型的 benchmark 數據和具體表現,也一點不像是原本我們對 Flash 的印象,即旗艦/Pro 模型的刪減版。
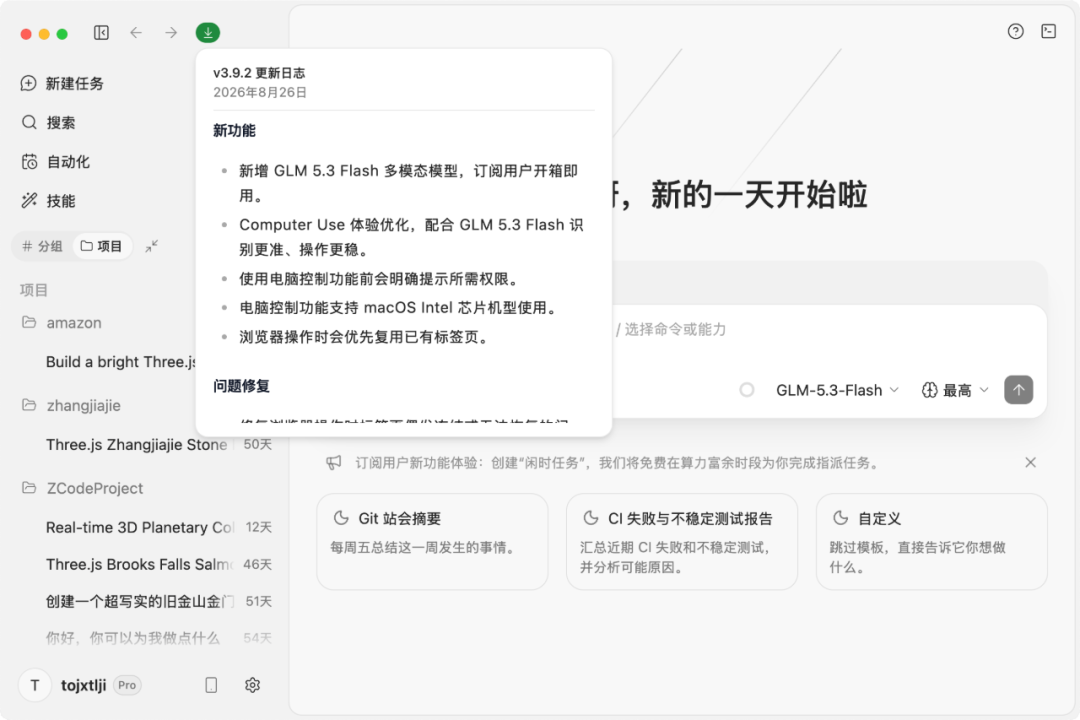
GLM-5.3-Flash 擁有百萬上下文,也是 GLM-5 系列的第一個原生多模態模型,圖片、視頻、文件、Coding,以及 Computer Use 這些功能現在全部靠模型就能做到。
Qwen3.8-Flash 同樣保留百萬上下文、圖像和視頻輸入,結合千問辦公,生成速度提升 100%,Token 消耗減少 75%。
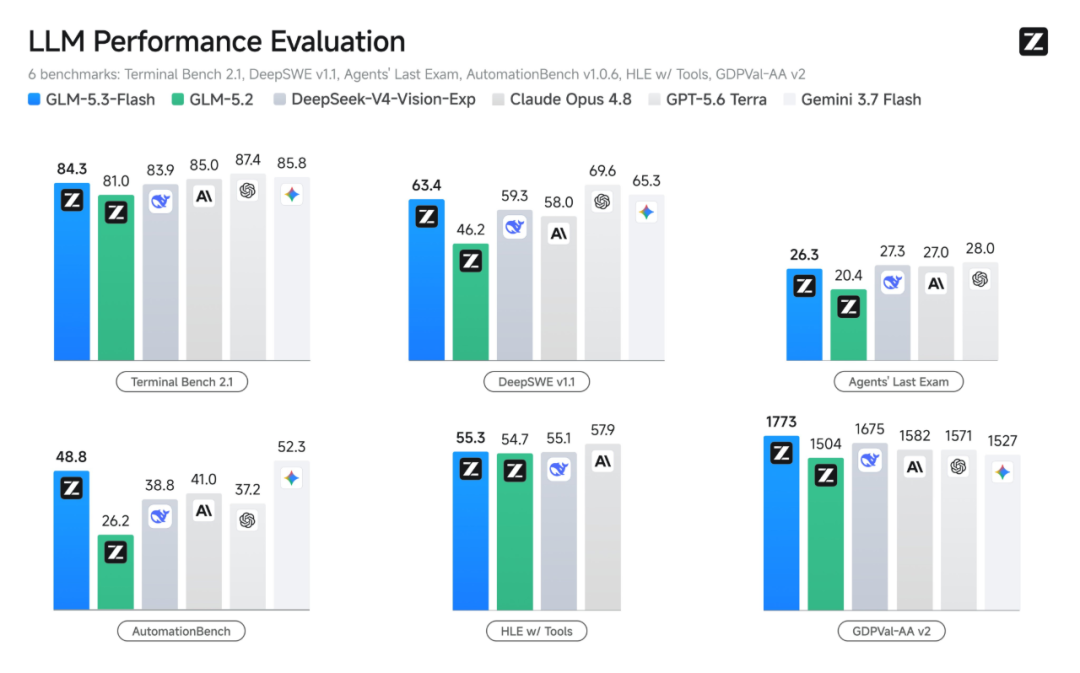
圖|GLM-5.3 Flash 在多個 benchmark 上的表現基本在 Opus 4.8 的水平
與此同時,極致性價比和普惠是這兩款模型的定位。GLM-5.3-Flash 的定價前所未有,限時折扣內每百萬 Token 輸入是 0.4 元,輸出 1.4 元,緩存命中 0.115 元,是 GLM-5.3 的 1/20。
Qwen3.8-Flash 的價格同樣感人,每百萬 Tokens 輸入僅 1 元、輸出 3 元,是 Qwen3.8-Max 的 1/12。
作為對比,現階段漲價後的 DeepSeek V4 Flash 價格是每百萬 Token 輸入是 1.5 元,輸出 4.5 元,緩存命中 0.05 元,而高峯時段還是空閒時段的兩倍。目前高峯時段為北京時間周一至周五 9:00 - 12:00、14:00 - 18:00,其餘為空閒時段。
一邊要比較模型界的「拼多多」DeepSeek V4 Flash 的價格,一邊又要比較智能上限,動不動就對標 Claude Opus 5、Fable 5 等。
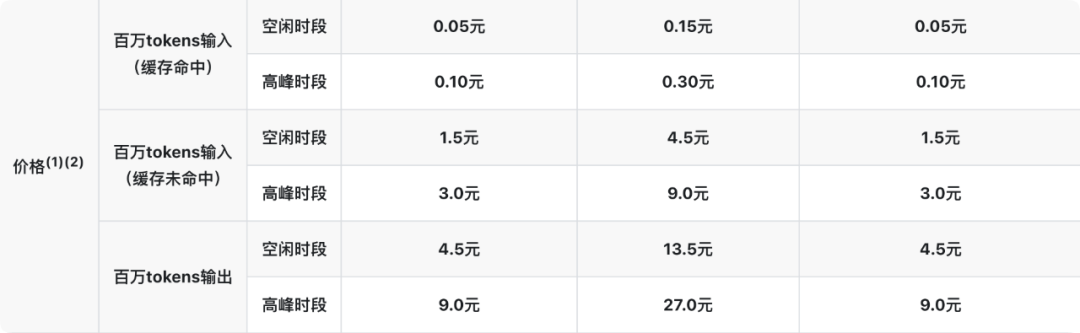
圖|DeepSeek V4 系列模型價格,從左至右為 V4 Flash、V4 Pro、V4 Flash Vision 實驗版
Flash 似乎正在擺脫過去「砍參數、砍多模態、砍上下文」換低價的定位,從一句「夠用就好」,變成大模型廠商新的競爭重點。
和 Opus 4.8 得分持平
OpenCode 的界面仍然顯示着,ox-alpha 有 50.5 萬個獨立用戶標識,累計消耗 Token 達到了 44T,完成超過 1300 萬個會話,輸入 Token 的緩存比例達到 93%。
這些數字能證明大量調用發生在 Coding Agent 平台,即便是匿名身份也沒有阻擋住開發者對這款新模型的使用熱情。
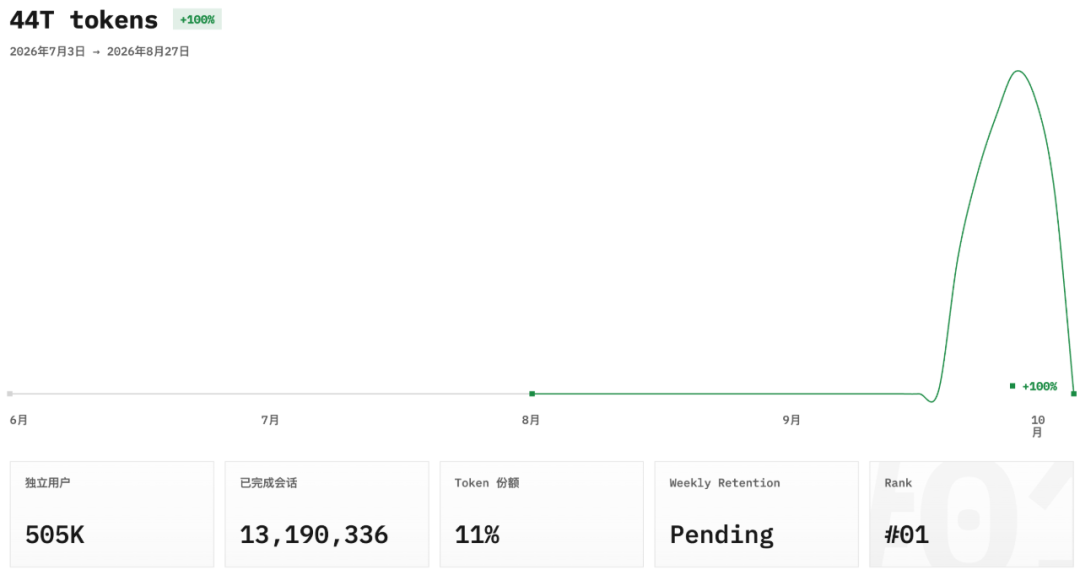
持續的調用,讓這個「牛來」模型終結了 DeepSeek 在 OpenCode 上長達 56 天的霸榜。
而來自模型調用的算力壓力,智譜後續則提到,這些請求流量全部由國產芯片提供算力支持,他們調用了超過 10 萬張國產芯片做推理服務,並在技術文檔中表示其集群「硬件效率及單位 token 成本已經達到了與主流英偉達 GPU 相當的水平」。
我們簡單測試了一下 GLM-5.3-Flash 的能力,目前它在智譜官方的 Coding Agent 平台 ZCode 上可以直接體驗。官方平台的 BigModel、Coding Plan 等 API 接入也已經開啓調用。
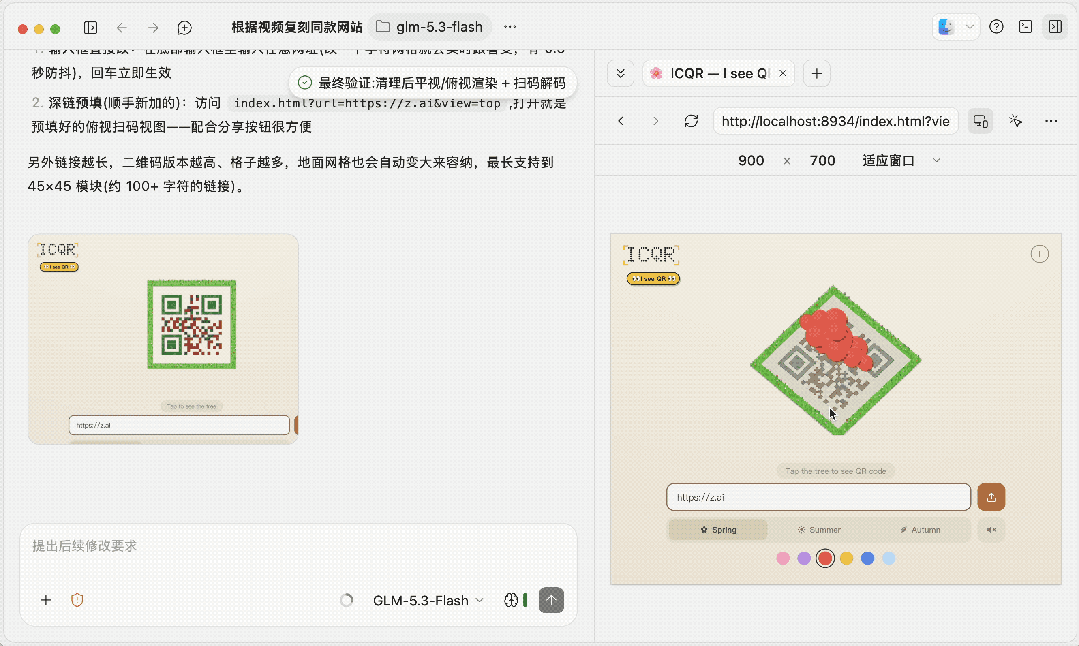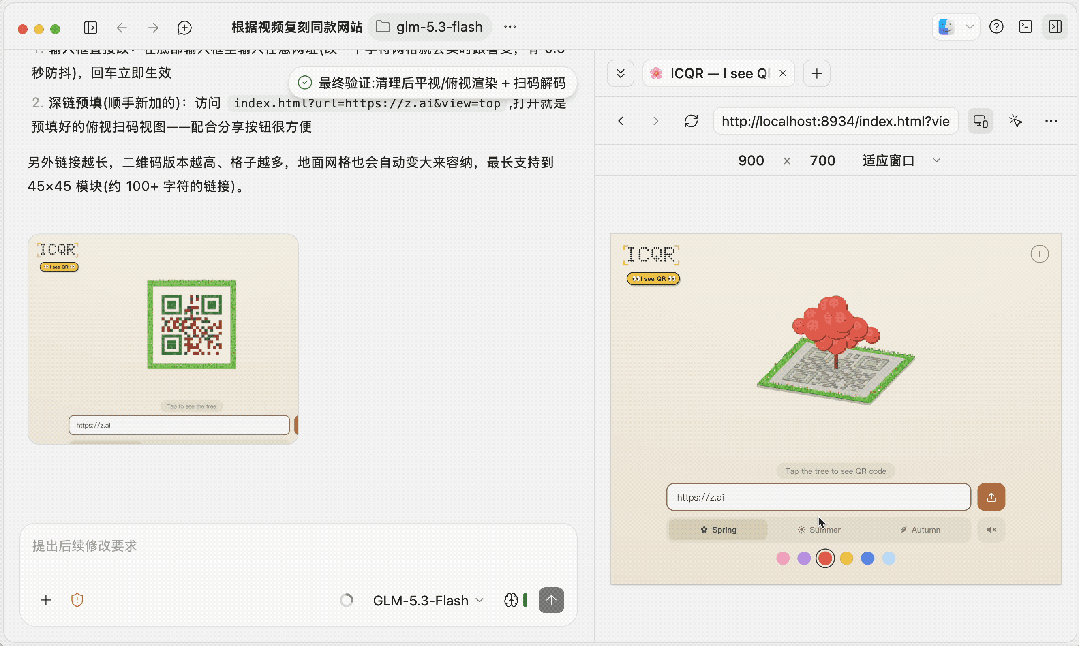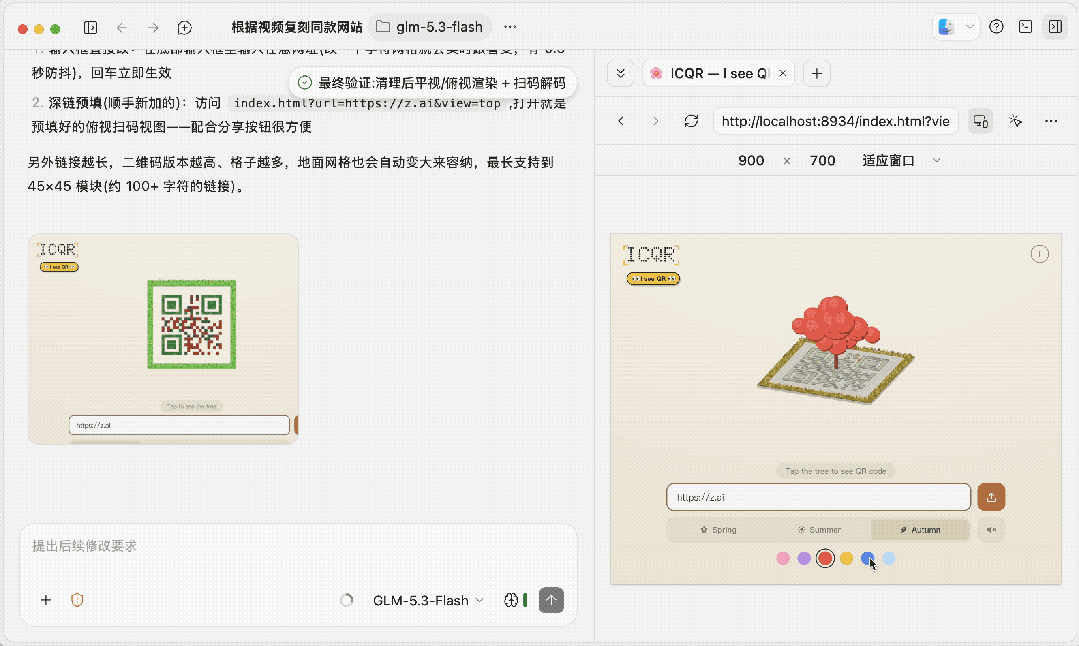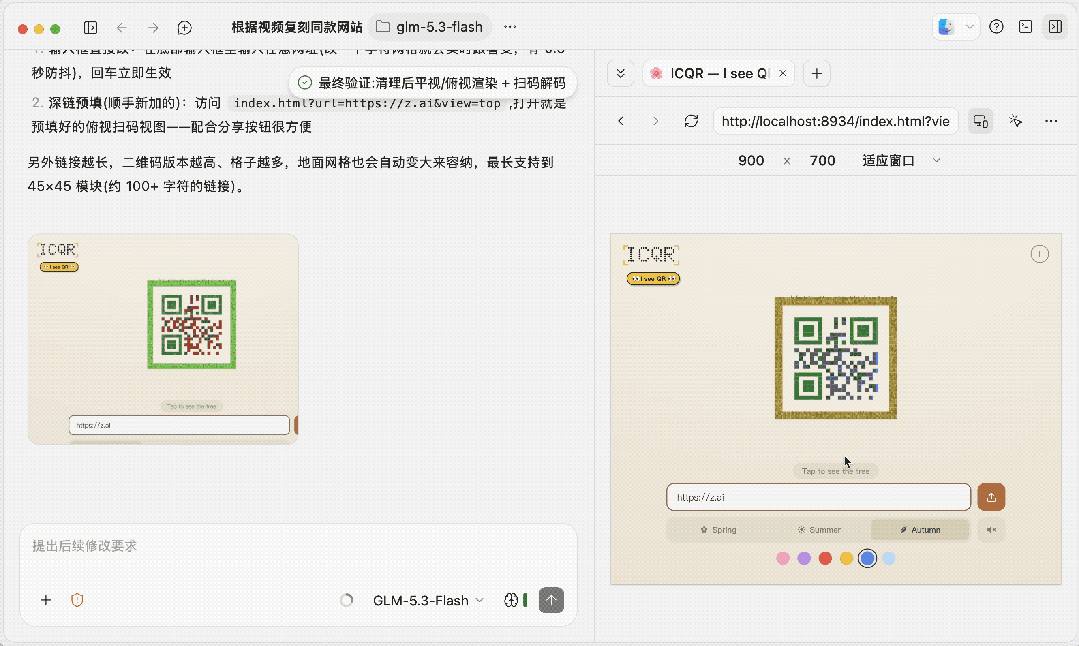
多模態的視覺能力是 GLM-5.3-Flash 的新增能力,我們上傳了 X 上最近比較火的二維碼項目視頻。平視是一棵樹,但是當我們拖拽鼠標切換不同視角,俯視時,這棵像素塊組成的樹就變成了一個可掃描的二維碼。
GLM-5.3-Flash 可以自動讀取視頻,但工作時間和我們之前的測試一樣,ZCode 要花較長的時間進行思考。似乎並沒有因為模型是 Flash,而導致任務的執行時間有變短。
最終實現的項目也是可以用的,但是如動圖所示,整個網頁非常卡頓。
我們要求 GLM-5.3-Flash 分析卡頓原因,它自己也提到,之前的實現每一幀都要重新繪製整個場景。
而整個場景有將近 1300 塊地磚,每塊最多 5 個面(頂面 + 4 面牆),再加投影計算裏每點都算一遍三角函數,鼠標拖拽的每幀,就有約 6000 次路徑填充、2 萬次三角函數,60fps 下非常喫力。
修復之後的版本要好上不少,動畫更加絲滑,拖拽也不卡頓,切換主題樣式時渲染都更快。
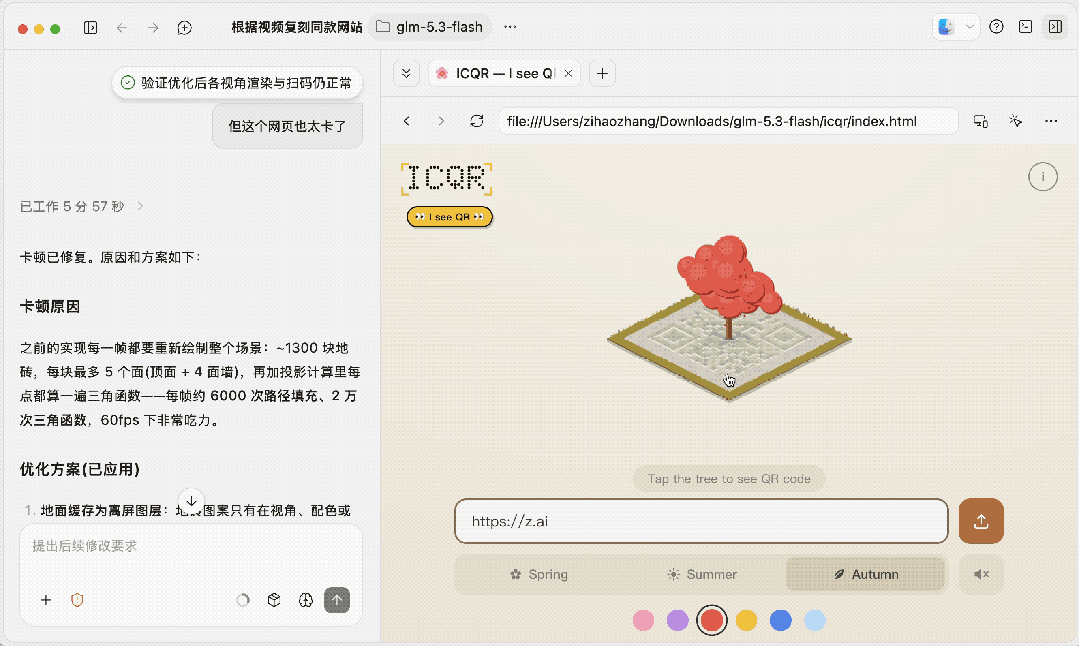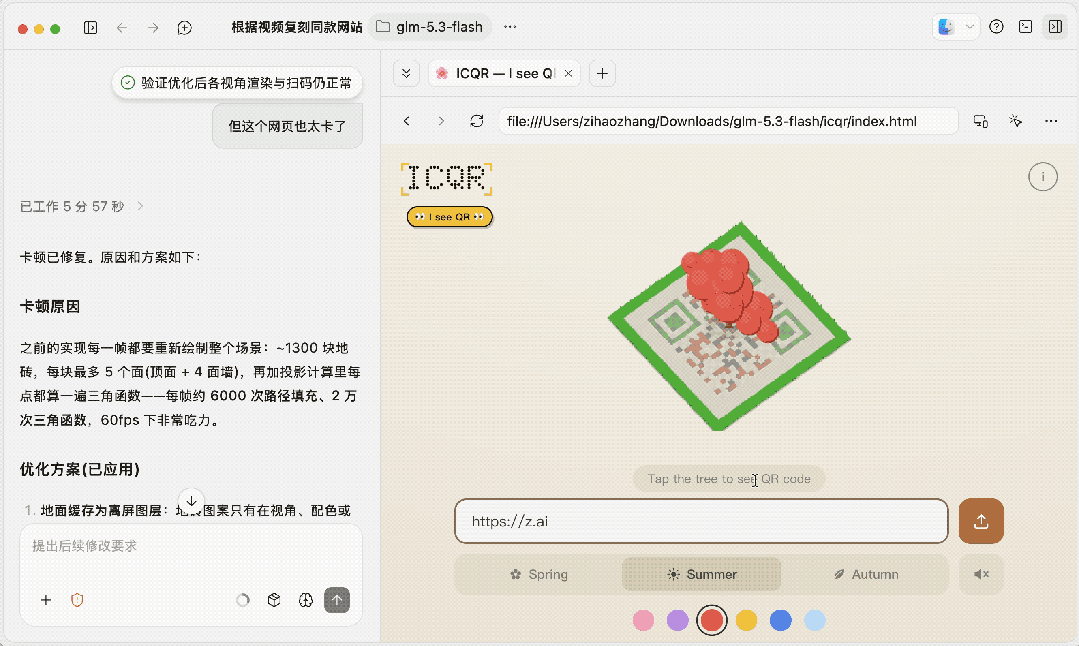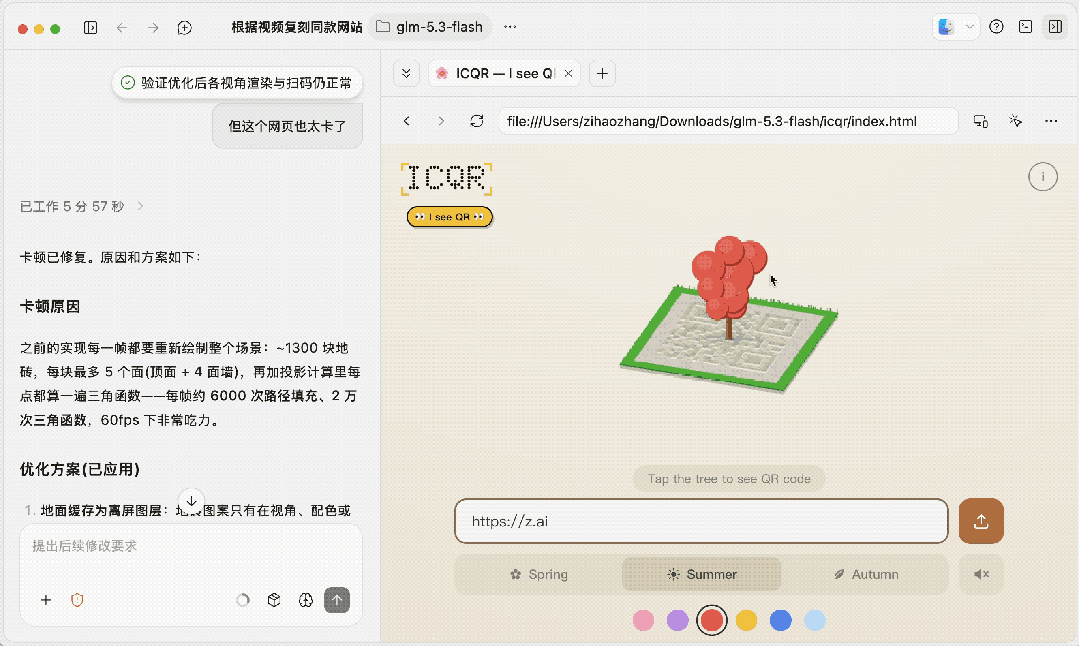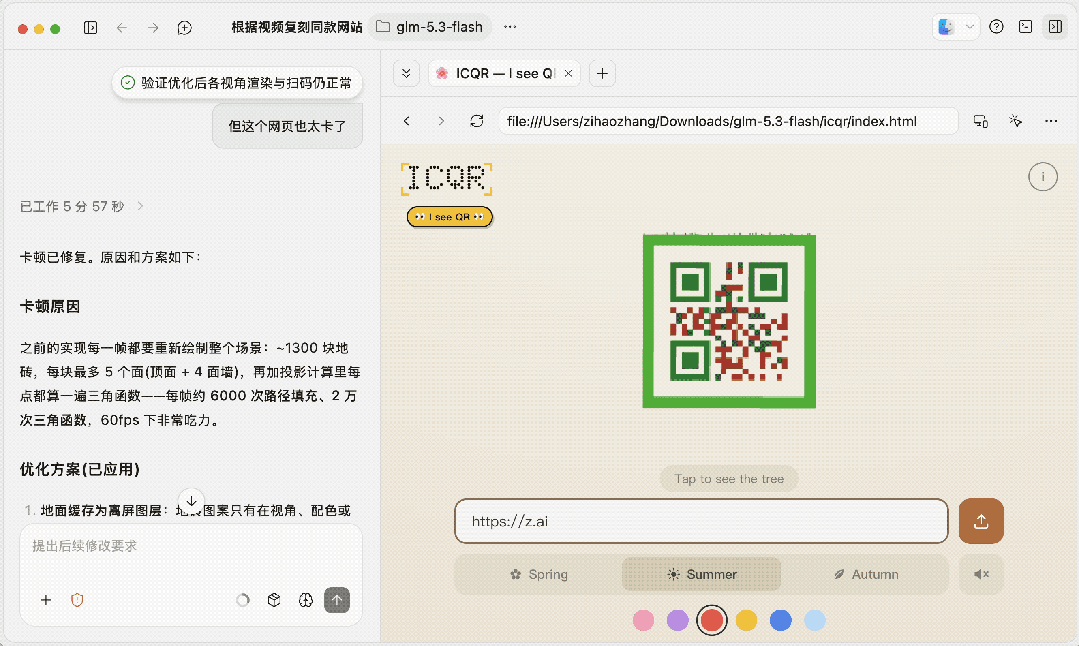
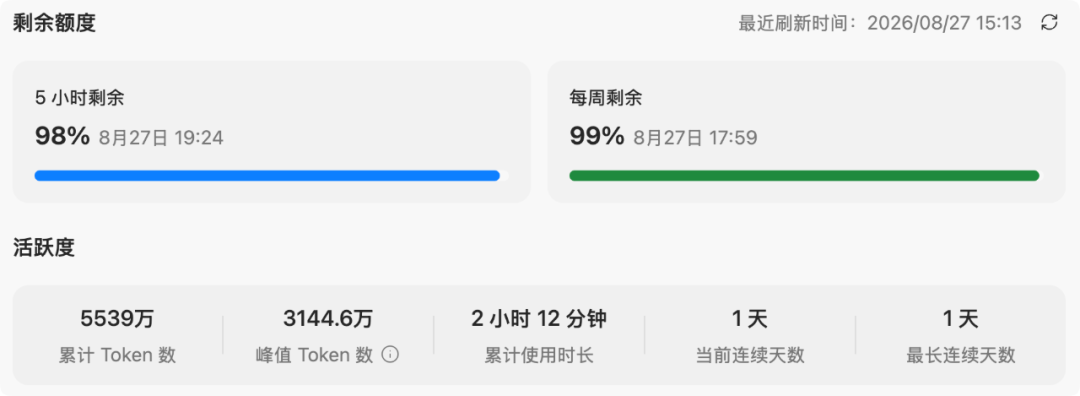
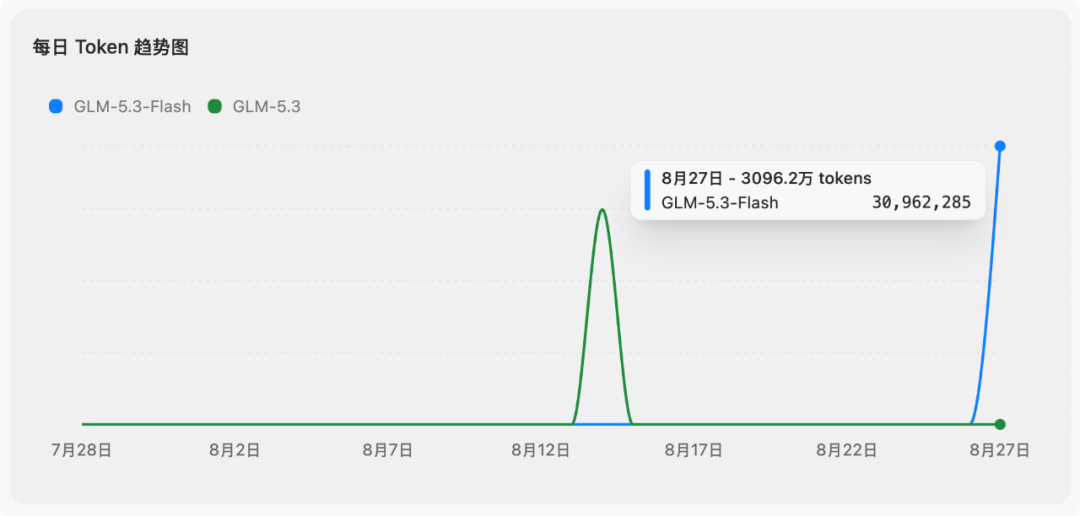
而整個項目從讀取視頻,到實現這個 3D 效果的二維碼網頁,以及二次修改;ZCode 內顯示的應用用量消耗是將近 3000 萬 Token,個人套餐內的 5h 剩餘額度還有 98%,每周額度則是剩餘 99%。
我們繼續使用 GLM-5.3-Flash 進行測試,模型的多模態能力很好地幫助 ZCode 可以持續截圖,通過視覺識別自身生成的內容,以及用「試玩」等方式來找到輸出結果中不合理的部分。
同樣是之前在 X 上比較熱門的中國寶塔案例,模型需要使用 3D 庫, 生成一座中國寶塔,朱漆綠釉,頂部飾以鎏金的完整搭建過程。
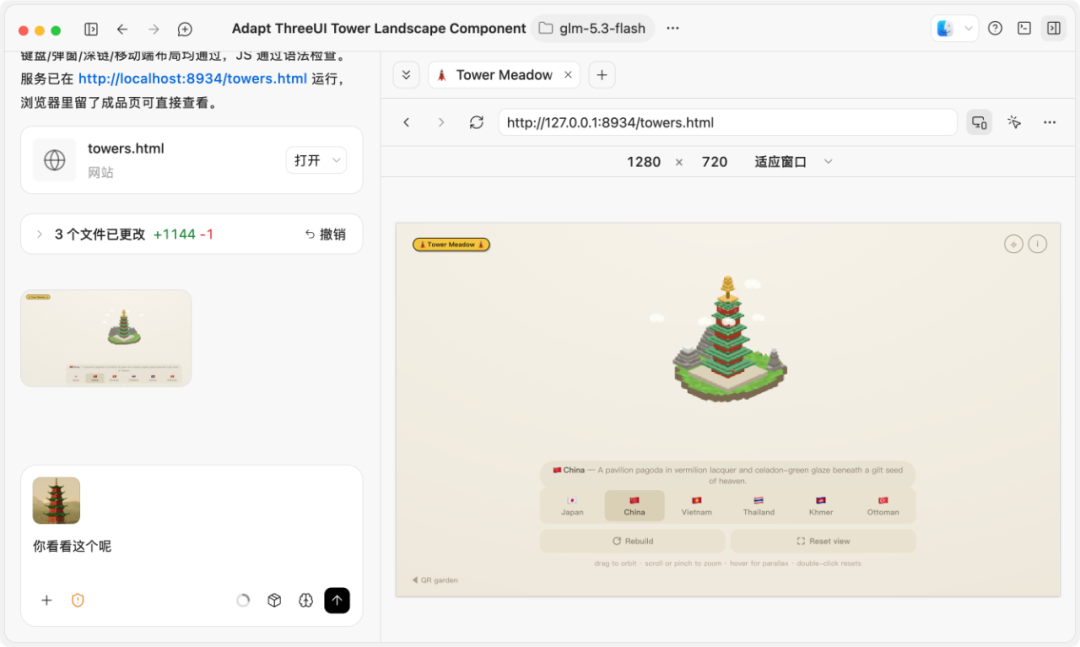
GLM-5.3-Flash 似乎參考了二維碼花園的項目,導致這個中國寶塔也採用了和之前一樣的像素風格,整個用時 57 分鐘,消耗 Token 大約在 1500 萬左右。
可以說,至少在我們的這輪測試裏,GLM-5.3-Flash 和 GLM-5.3 的體驗差距並沒有價格差距 20 倍那麼大。
注意力計算量、KV 緩存、激活參數和總參數可能已經發生了很大變化,但落到常規網頁開發、研究報告等實際任務上,這些差異並不明顯,GLM-5.3-Flash 也可以勝任。
Flash 正在越過斬殺線
同一晚發布的另一款 Flash 模型,也不「Flash」。
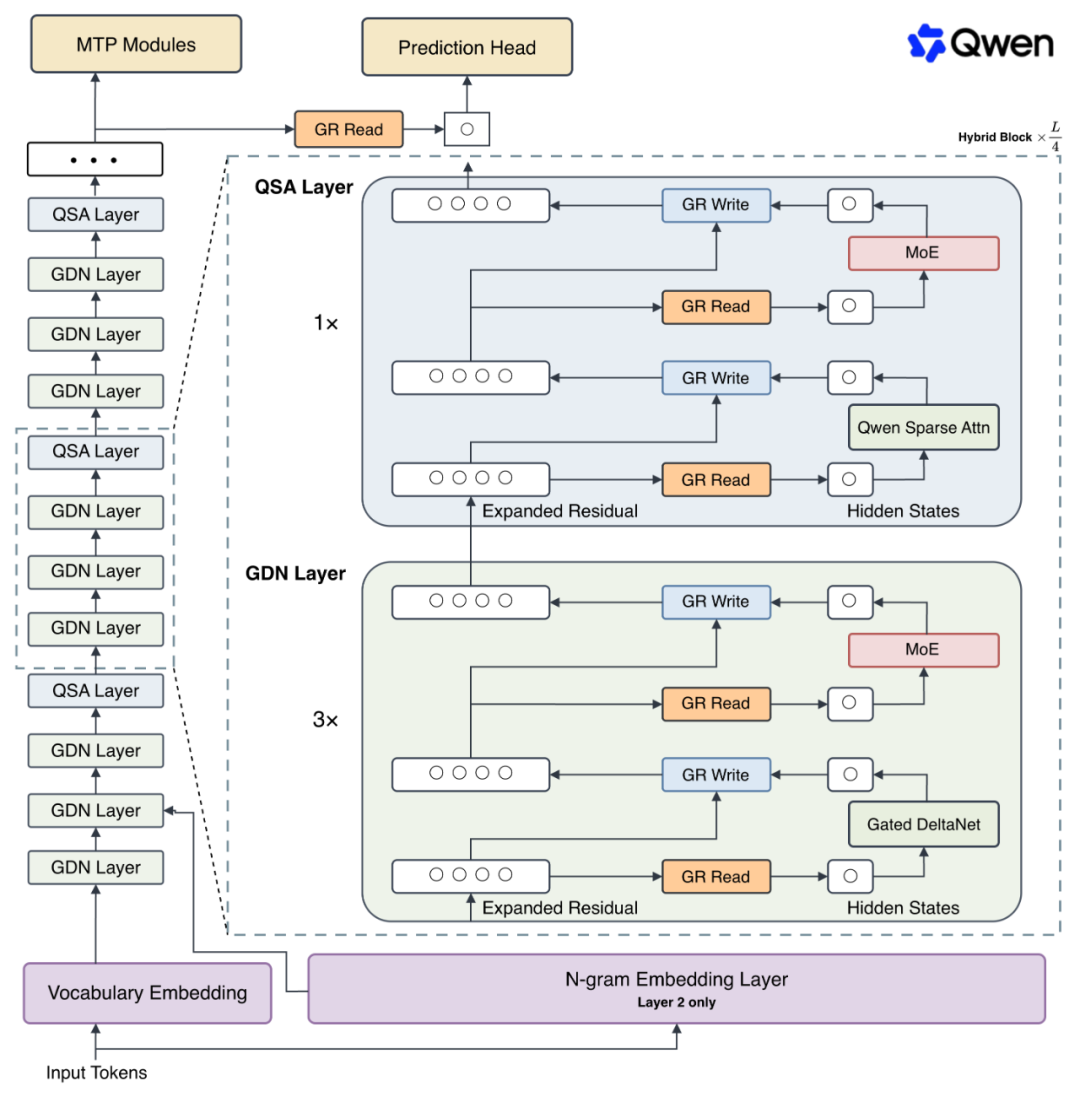
Qwen3.8-Flash 主模型 125B 參數,外加 51B 的 N-gram Embedding,每 token 只激活 6B 參數;原生支持 26.2 萬 token 上下文,可通過 YaRN(Yet another RoPE extensioN)擴展到 100 萬。
更特別的是,它直接採用了下一代 Qwen4 的新架構。相比 Qwen3.7-Plus,通過架構和注意力機制內核的調整,整體訓練成本降到約九分之一,編碼和辦公任務反而更強。
前段時間,我們在《DeepSeek 給大模型劃出的「斬殺線」,斬的到底是什麼》裏給「斬殺線」下過一個定義:足夠高的任務完成率 × 足夠低的總任務成本,從而奪走默認調用位。
當時看這似乎是 DeepSeek 的單點優勢,畢竟一直以來的印象,卷價格,沒有人能做到比 DeepSeek 低,智能水平,DeepSeek 也並不會讓人失望。
隨着智譜發布價格更低的 GLM-5.3-Flash,千問也發布未來結構、價格同樣便宜的 Qwen3.8 Flash,所謂的斬殺線已經不再是 DeepSeek 這一家模型廠商的敘事,更像是整個做大模型行業的新規則。
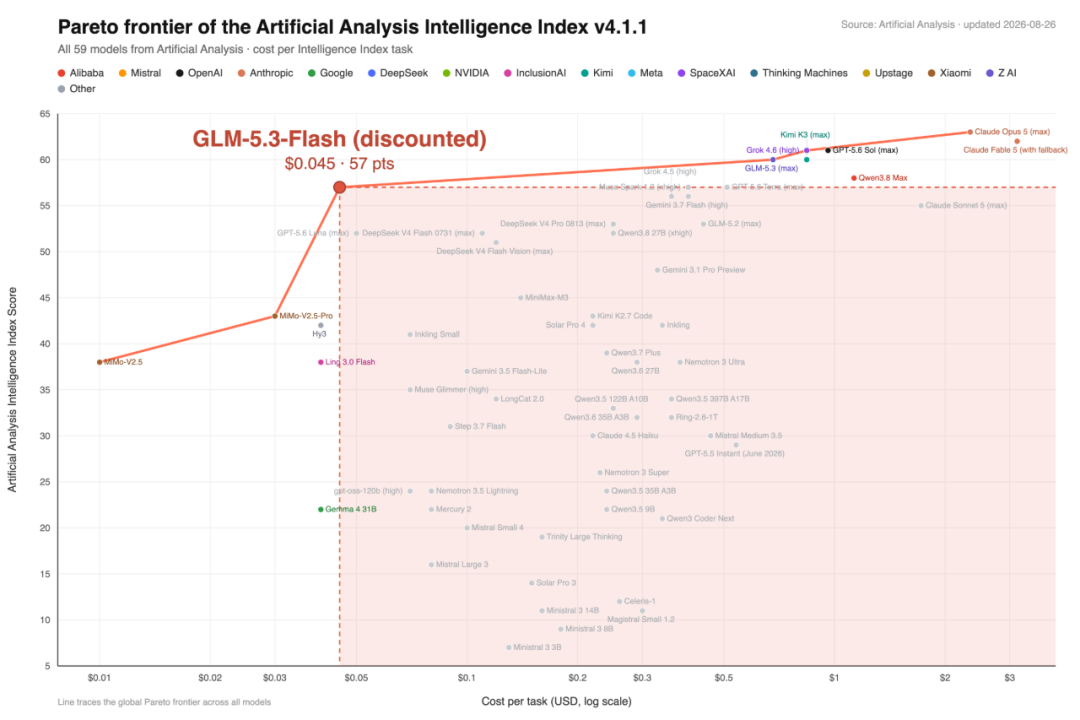
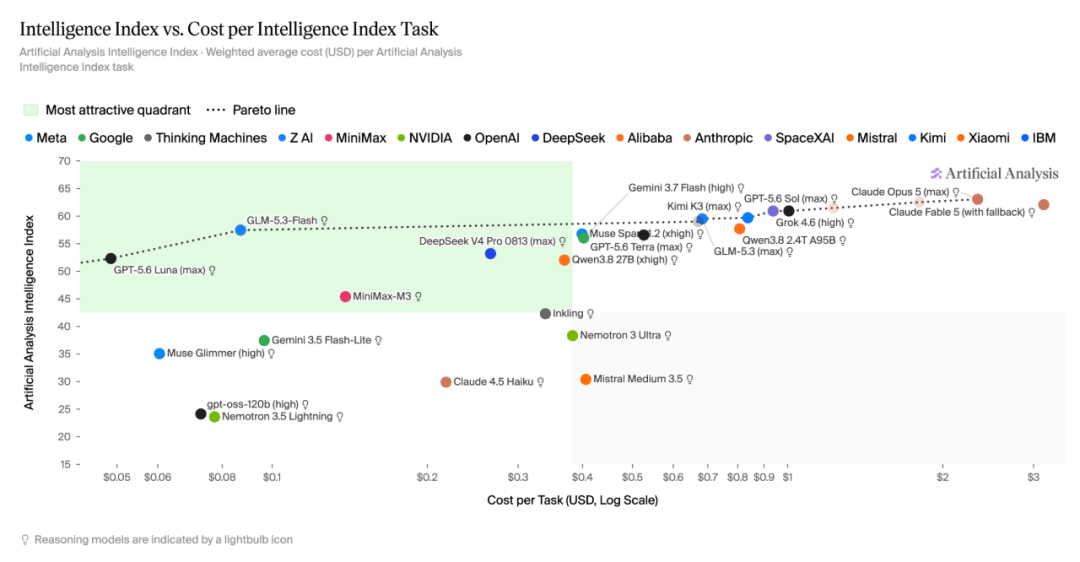
根據 Artificial Analysis 的測算結果,GLM-5.3-Flash 單次任務的成本比 DeepSeek V4 Flash 低,且智能水平要比 V4 Flash 和 V4 Pro 都要高。
當百萬上下文、原生多模態和 Coding Agent 開始成為標配,模型廠商正在做同一件事:把過去接近旗艦級的能力,壓進 Flash 的價格帶。
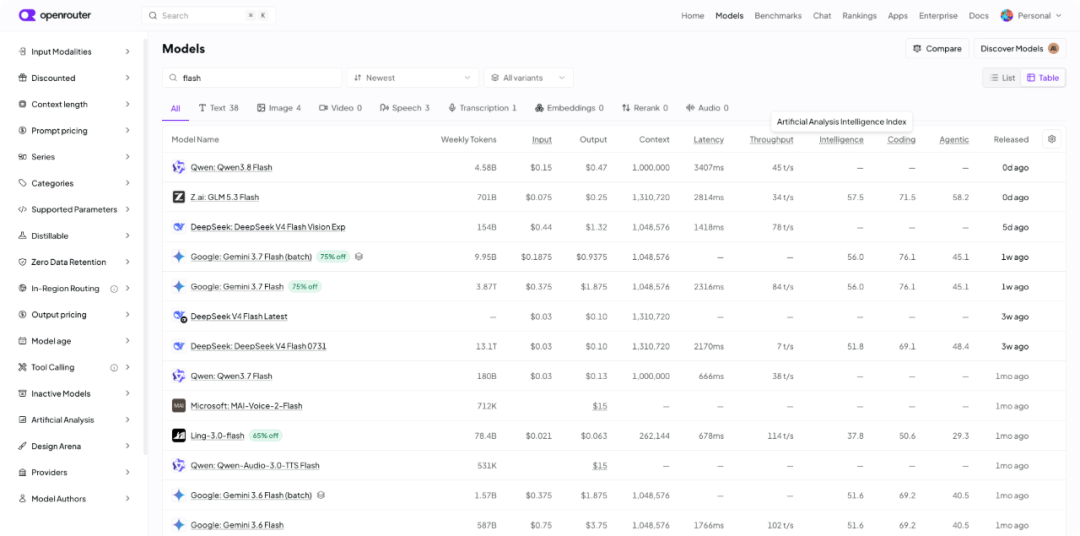
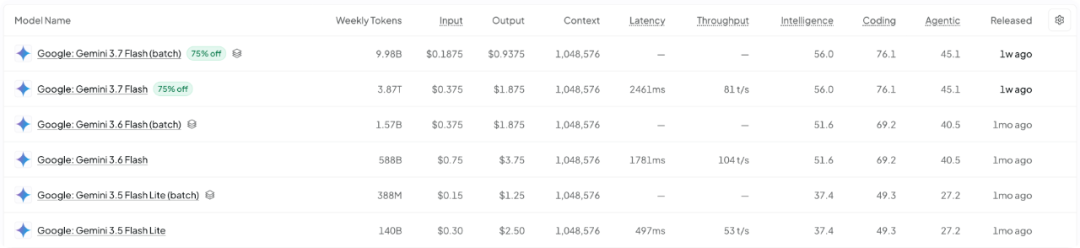
圖|最近一個月發布的 Flash 模型情況
有意思的是,從今年 2 月發布 Gemini 3.1 Pro 之後,Google 就再沒發過任何 Pro 模型。他們在五月發布 Gemini 3.5 Flash、七月發布 Gemini 3.6 Flash、八月發布 Gemini 3.7 Flash……
現在看來,原來 Google 一直發布 Flash 是看中了這塊斬殺線。
過去的 Flash 依靠削減能力,比如縮減上下文、剝離多模態來換取低價,匹配對應的市場;而現在的 Flash 保持功能全量,僅通過極低的高效激活參數,像是百億級激活/幾百億總參數,來壓縮單 Token 邊際成本。
在眼下「無處不消耗 Token」的背景下,讓更多的用戶可以大膽地在後台運行着一個自己的「全天候 Agent」,或工作中小到轉換圖片格式、文檔格式這樣的工作,都能直接丟給 AI。
而更昂貴的旗艦模型,在更多的時候則是退到了非選不可的情況,只有我們在觸發到任務困難、Flash 做不好的情況,或者讓 Pro 決策,用 Flash 執行等。
另一方面,Flash 帶來的變化也在模型迭代路徑上體現,過去是「旗艦先發 $ightarrow$ 蒸餾縮小 $ightarrow$ 推出 Flash」;現在則演變為「高效架構(如新型 MoE、預測草稿 Token)先在 Flash 驗證 $ightarrow$ 再拓展至旗艦」。
效率工程本身成為了行業的最前沿,Flash 架構的創新密度甚至開始超越旗艦。
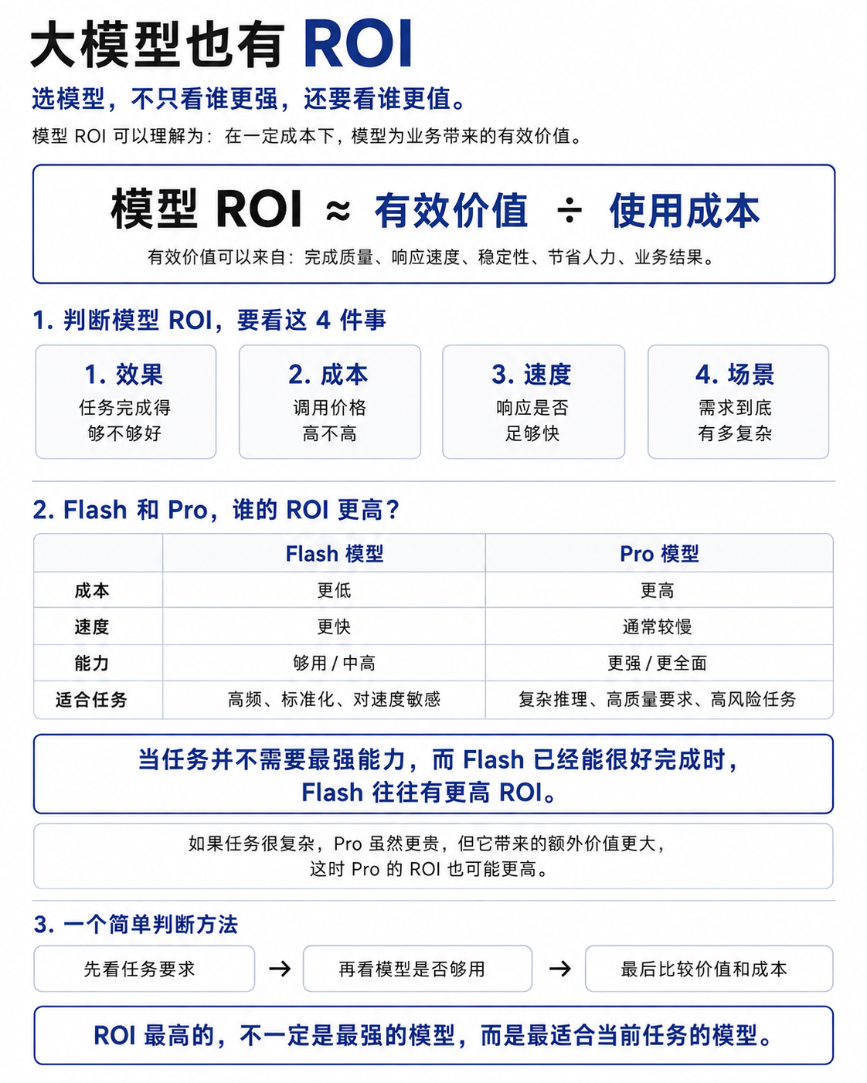
所以今天再問什麼是 Flash,答案已經變了。以前,它意味着更快、更便宜的輕量模型;現在,它代表的是足夠高的任務完成率,以及足夠低的任務成本。
哪怕生成速度只有 50 Token/s,只要它擁有視覺自檢與長文本推理能力,能穩妥跑完耗時 10 分鐘的複雜 Coding 或辦公工作流,它在商業層面就已經斬斷了傳統低端模型的生存空間。
過去,我們總想默認使用「最聰明的模型」。接下來,默認調用位可能屬於那個足夠聰明、足夠便宜,因此可以放心一直開着的模型。
這是 Flash 越過斬殺線之後帶來的變化,旗艦模型決定 AI 的上限,而 Flash 決定我們每天到底用哪個 AI。