新智元報道
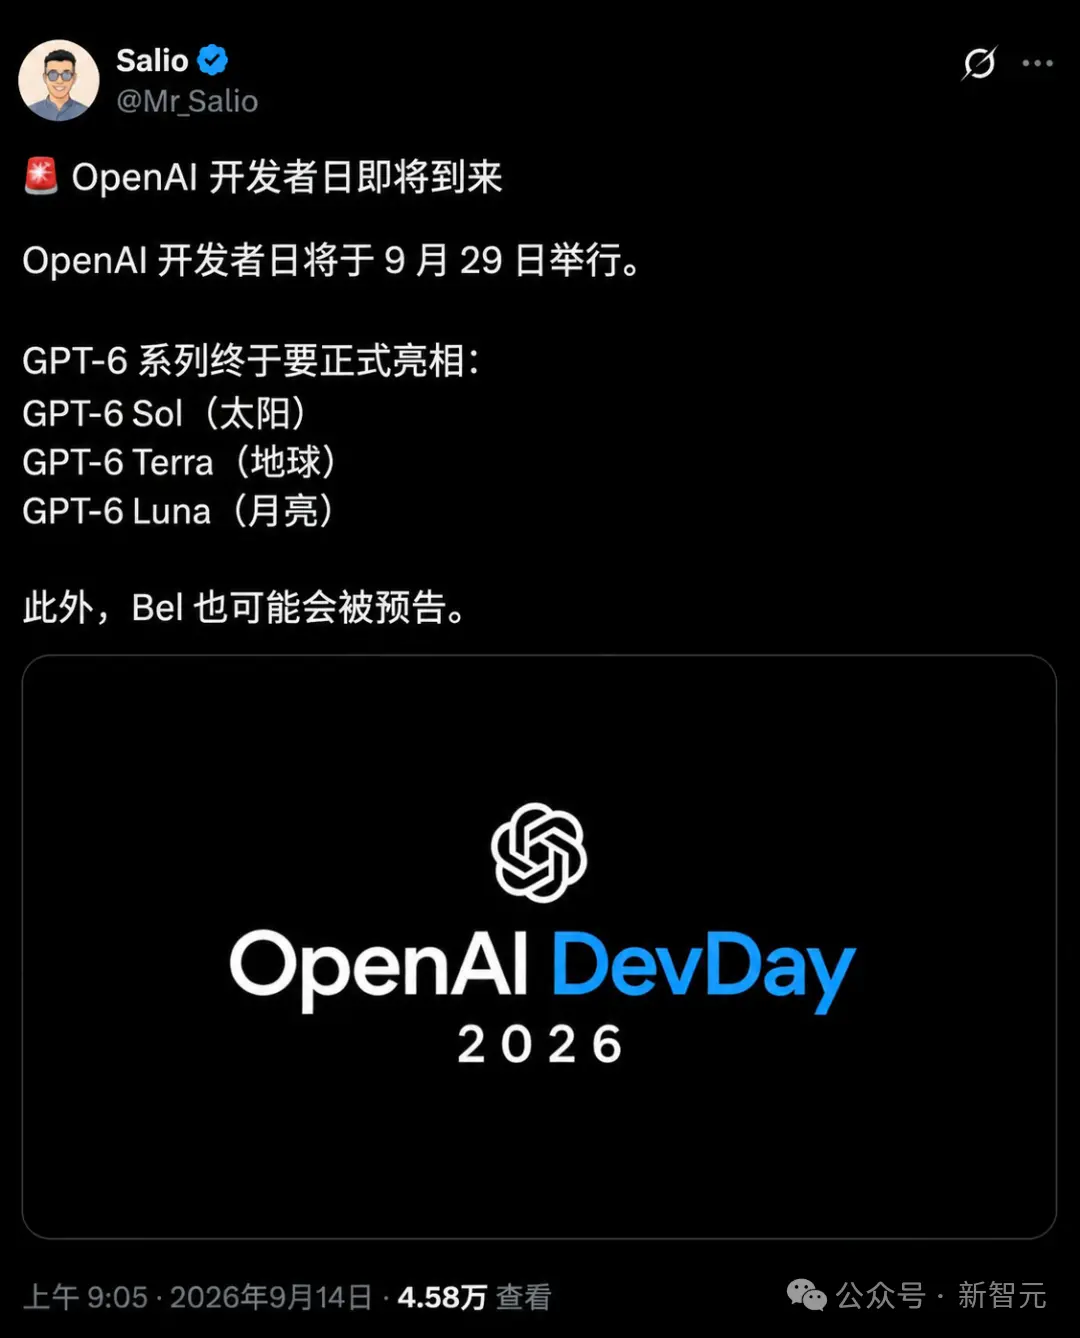
重大消息:GPT-6 Sol 正在內部測試,且已在 OpenAI API 中被發現,預計本月正式發布。
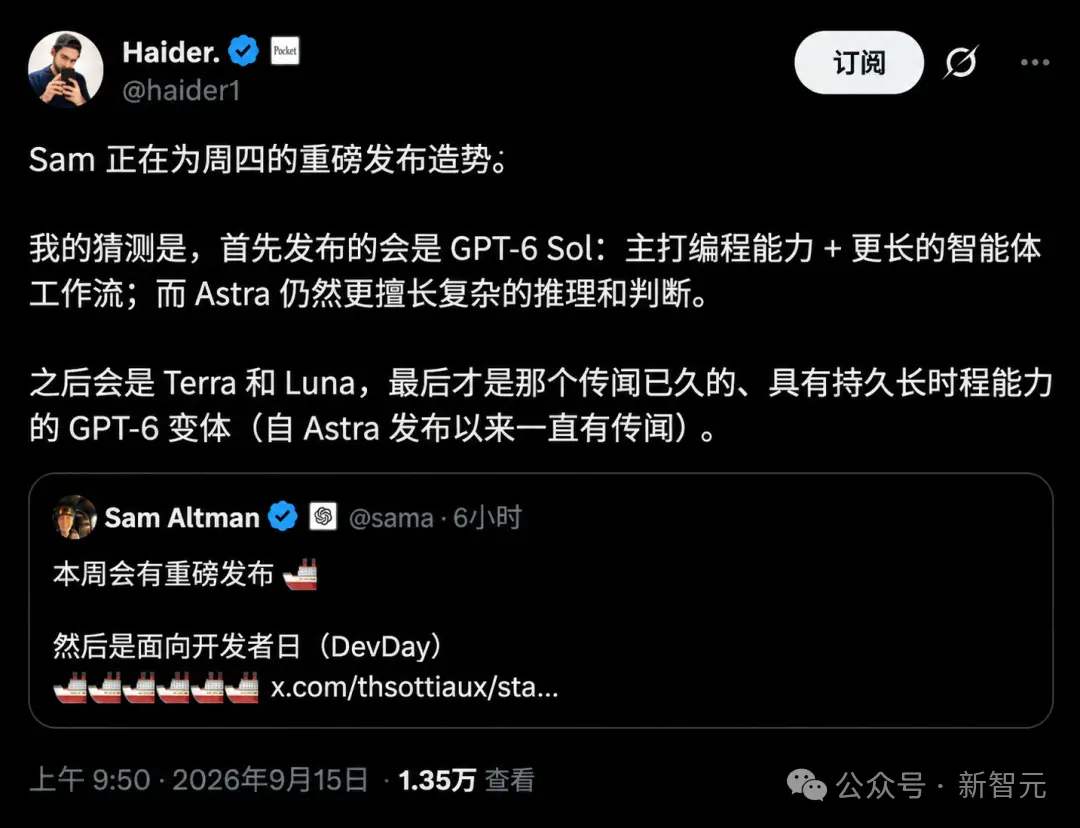
就在昨天深夜,奧特曼的一句爆料,讓所有人都興奮起來。
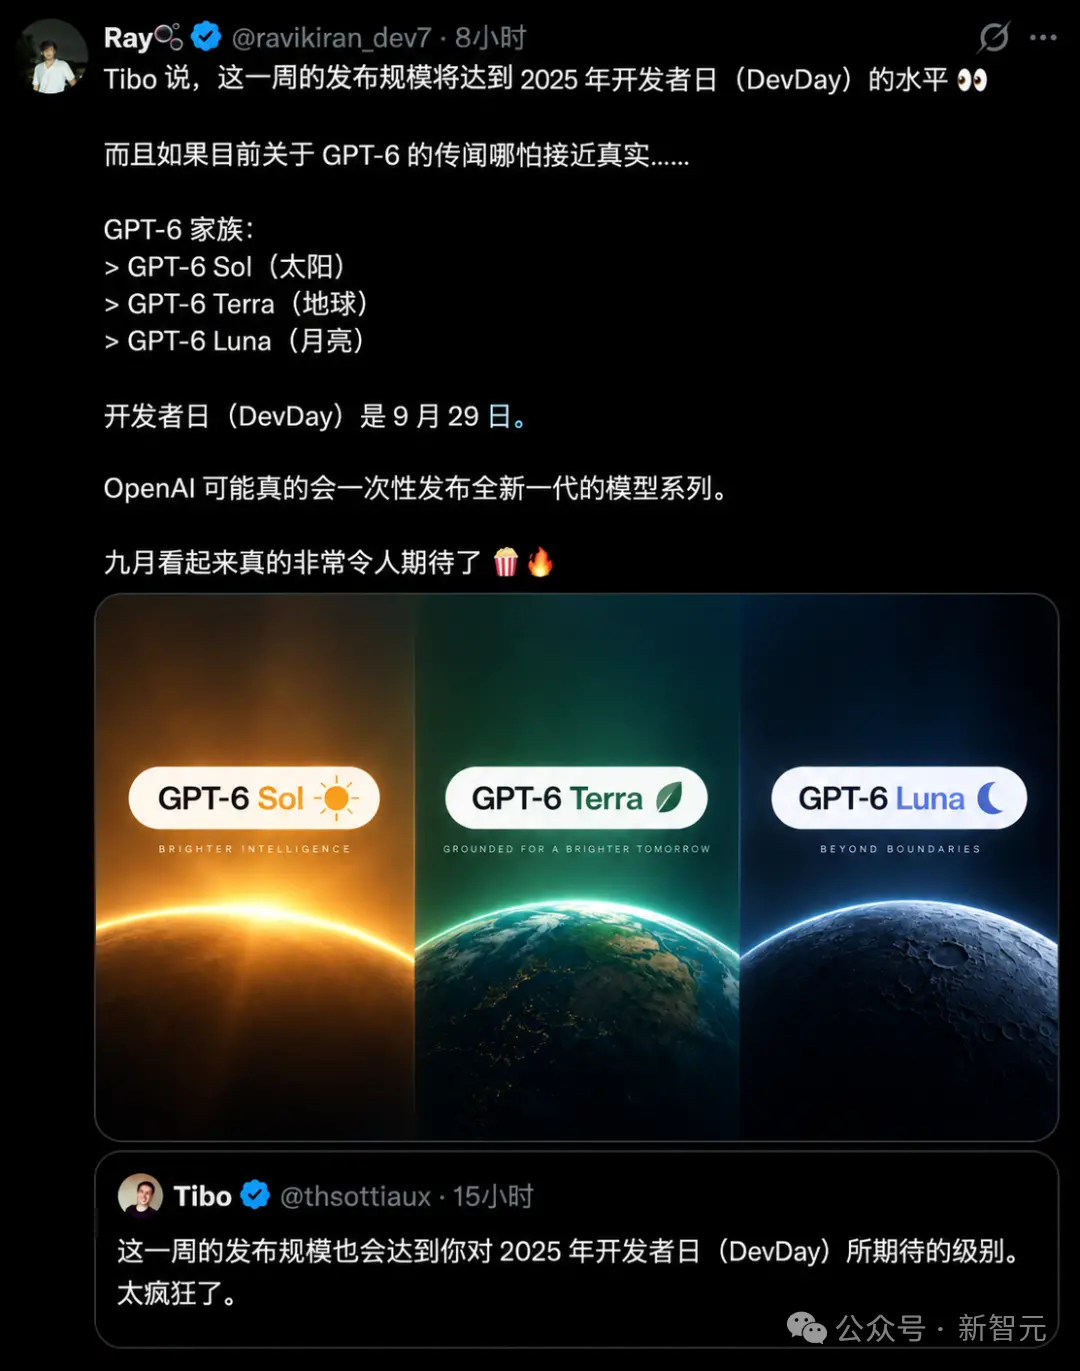
他發了一個「(Ship/發布)」的表情,並配文:「這周將有大動作。然後,我們 DevDay 見。」
重置哥 Tibo 更是直言不諱:「本周的發布力度,將達到你原本對 DevDay 2025 預期的水平。簡直瘋狂!」
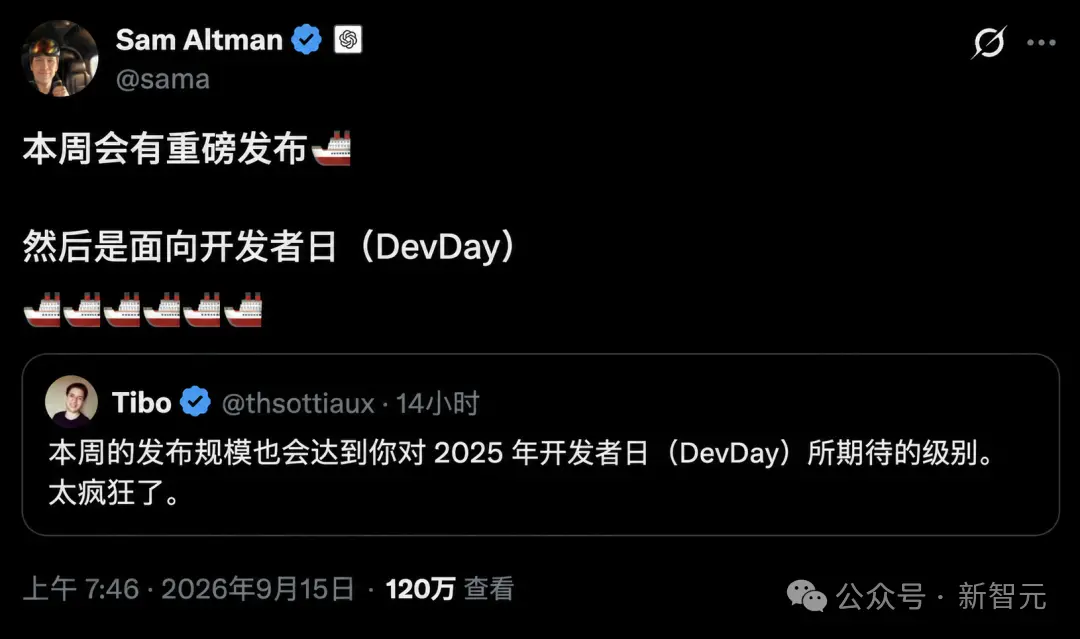
圈內的最新爆料,也印證了他們的說法:Opus 5.2 和 GPT-6 Sol,都會於本月上線。
現在,已經有衆多開發者發現,自己手中的 5.6 Sol,已經被悄悄自動路由至全新的「GPT-6-Sol」!
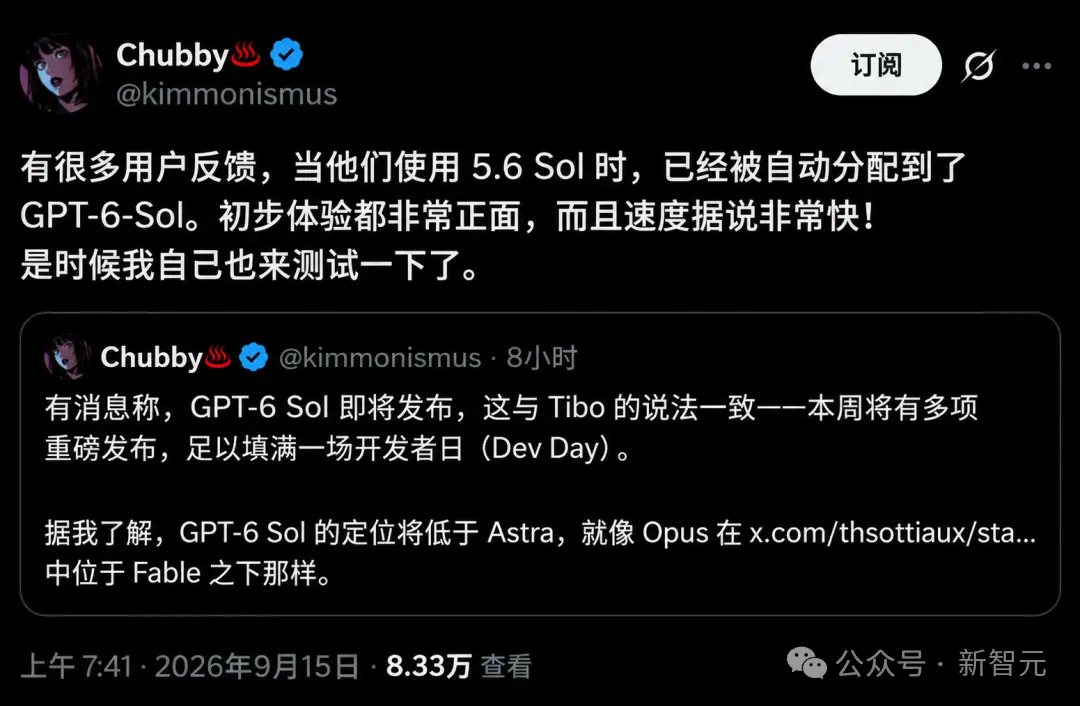
實測反饋,可以用四個字概括——快到飛起。
三連爆:GPT-6-Sol 實測震撼
而且就在昨天,已經有關於 GPT-6 Sol 的實測案例流出了。
一個名叫 Salio 的大 V,連續甩出了關於 GPT-6 Sol 的三彈重磅泄露。
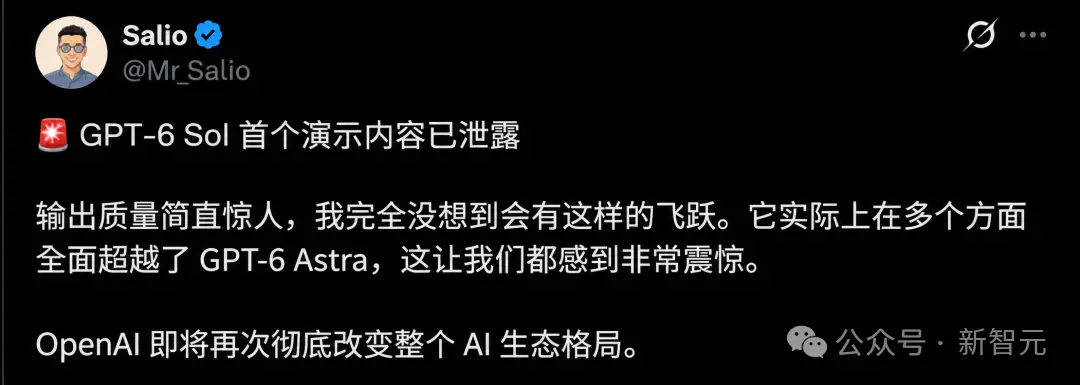
第一彈:質量驚人,碾壓 GPT-6 Astra
在 GPT-6 Sol 的首個演示中,它的輸出質量體現了巨大的飛躍。
而且,在多個方面上,它幾乎全面超越了 GPT-6 Astra。
第二彈:編程與前端的降維打擊
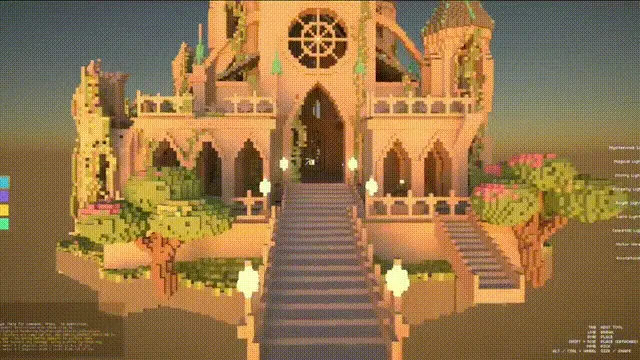
第二段泄露顯示,GPT-6 Sol 在編程和前端生成上擊敗了 GPT-6 Astra,輸出質量簡直「逆天」。
更可怕的是,它的生成成本被壓得極低,價格要便宜得多!
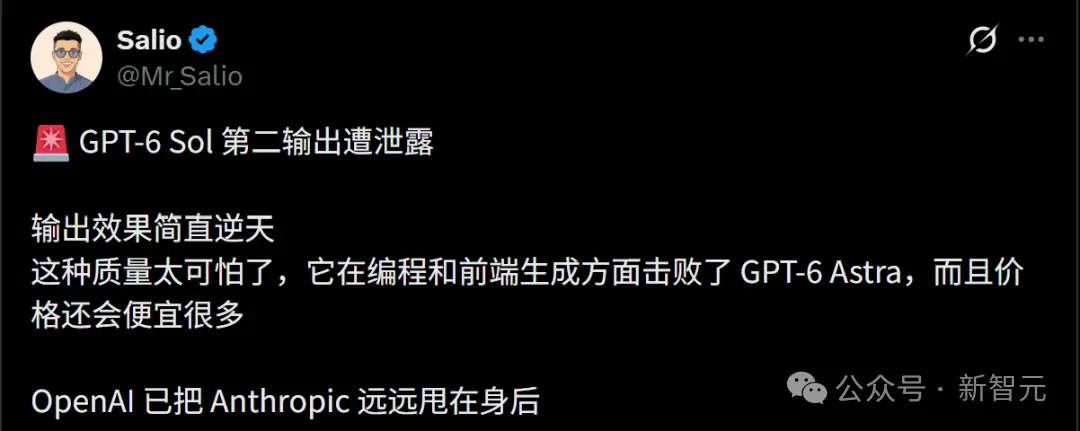
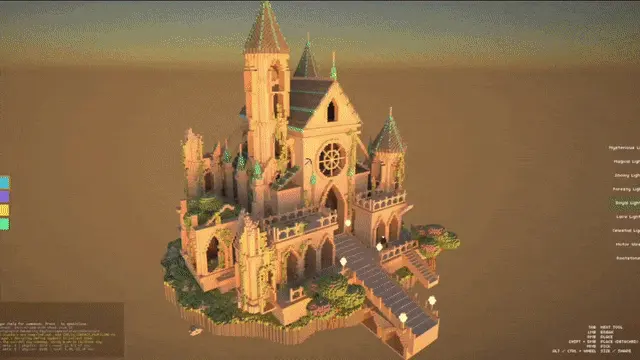
實測開發者評論說:「OpenAI 這是要把 Anthropic 遠遠甩在身後了!」
第三彈:視覺生成與遊戲創作的質變
第三彈顯示,GPT-6 Sol 在視覺生成和遊戲創作上,都有了巨大飛躍。
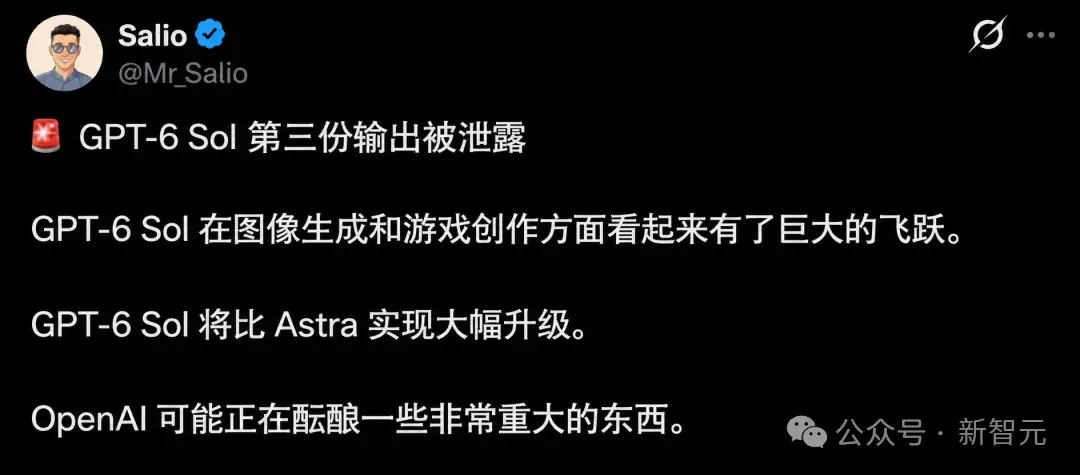
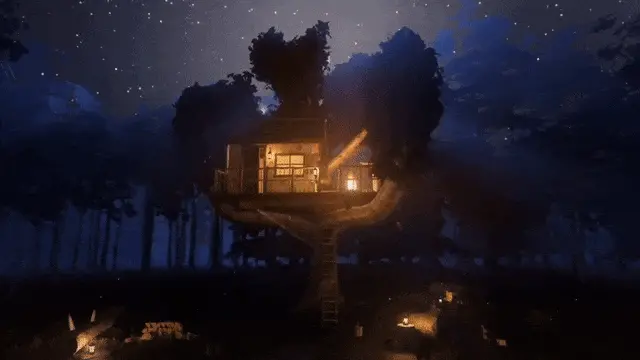
在動態畫面生成、實時交互場景以及遊戲引擎級創作上,Sol 都令人印象深刻。
在下圖中,畫面細膩度和邏輯連貫性表現驚人,測試者評價說,這絕對是對 Astra 的一次重大升級。
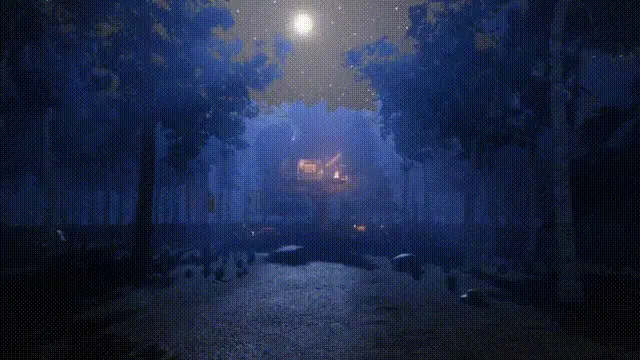
現在,已經有越來越多開發者在 API 列表中捕捉到 gpt-6-sol 的身影了,太讓人期待了。
GPT-6-Sol:比 Astra 更強,卻更便宜?
所以,GPT-6-Sol 的真實定位到底是什麼?
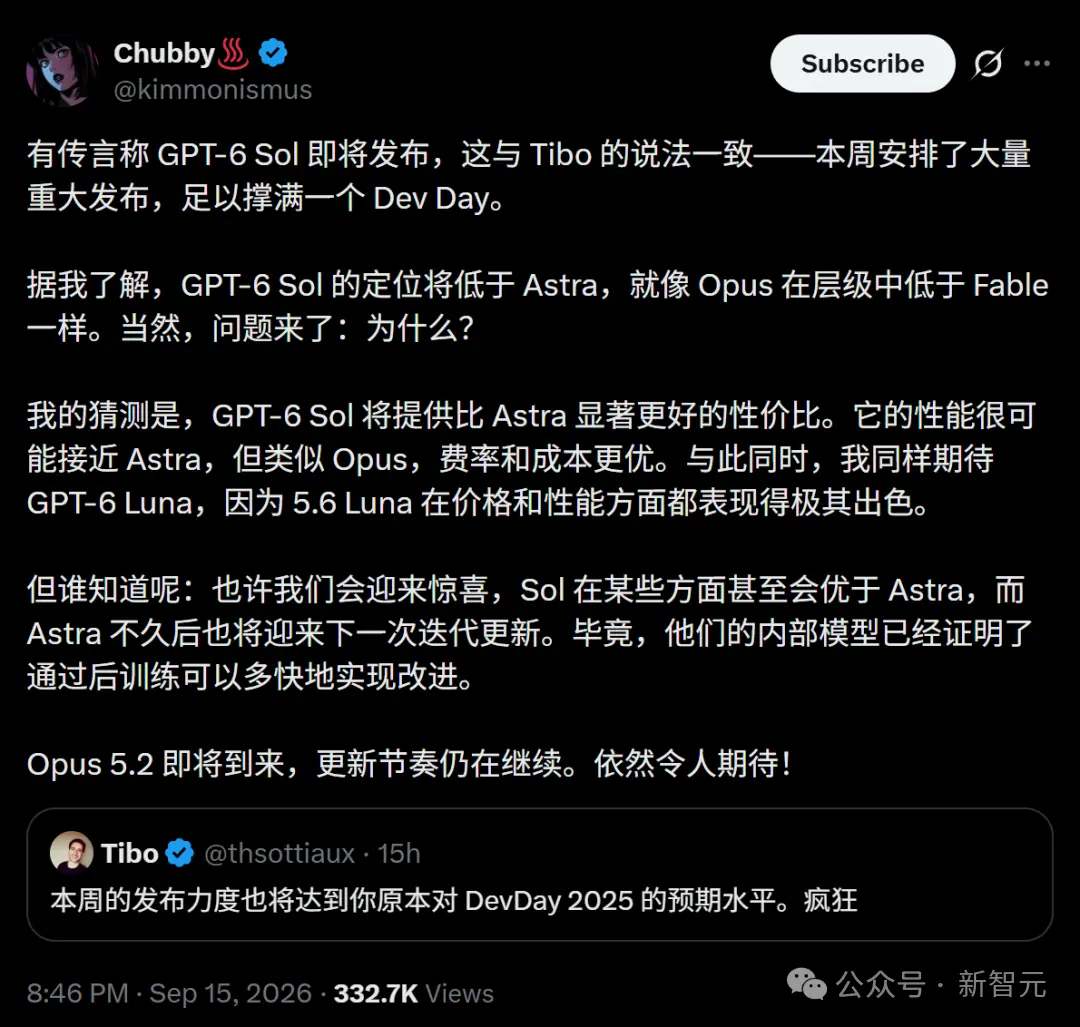
根據爆料,GPT-6-Sol 的定位預計將略低於 Astra,可以類比於 Anthropic 體系中,Opus 低於 Fable 的微妙層級關係。
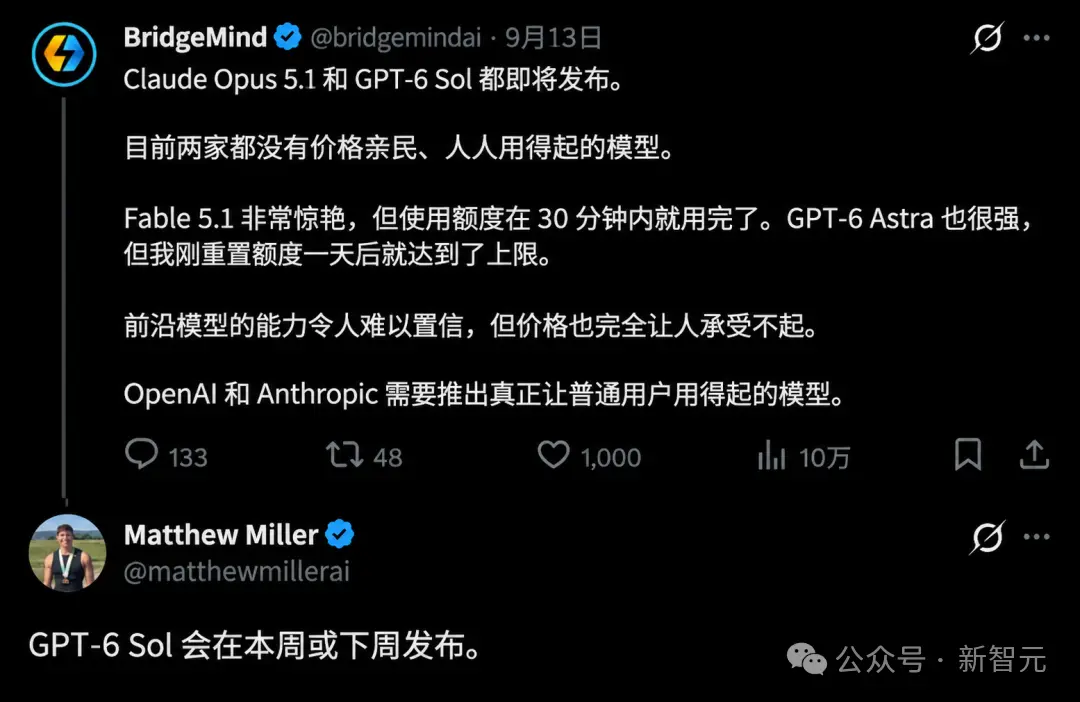
為什麼要推出一個低於旗艦的型號?答案自然是——極致的性價比!
從目前流出的實測數據來看,GPT-6-Sol 的性能無限逼近 Astra,但在費率、調用成本和響應速度上,它卻擁有壓倒性的優勢。背後原因,很可能是精妙的後訓練優化。
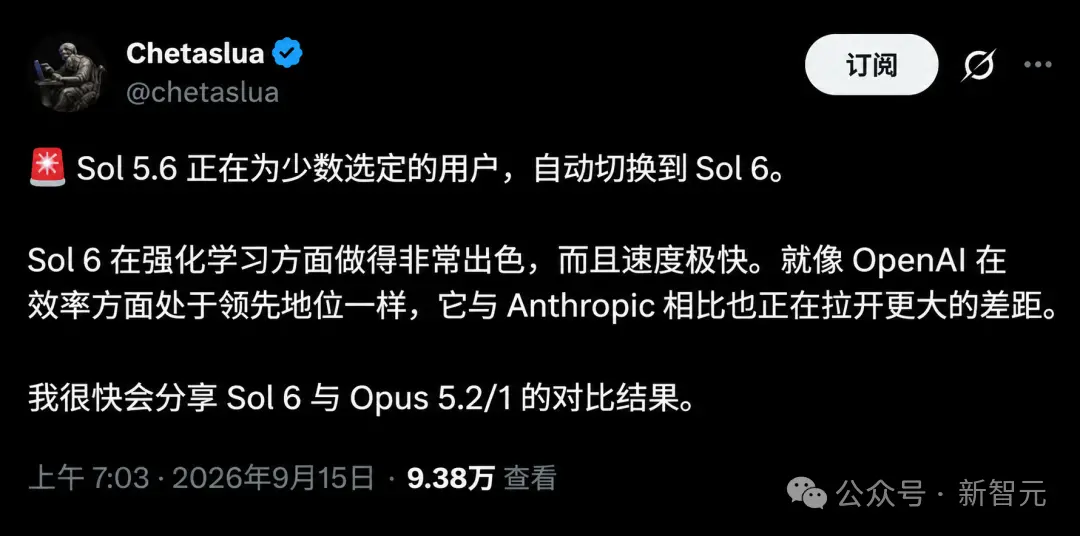
這意味着,頂級模型不再是天價奢侈品。
對於 99% 的日常工作和開發者來說,Sol 在成本和調用額度上將比 Astra 友好得多,註定將取代以往的模型,成為所有人每天高頻使用的絕對主力。
除了 Sol,呼聲極高的還有 GPT-6-Luna。
此前 5.6 版本的 Luna,就以離譜的性價比著稱,這次 Luna 的迭代同樣令人期待。
不幸的是,種種內部爆料暗示,GPT-6 Terra 或將退出歷史舞台。
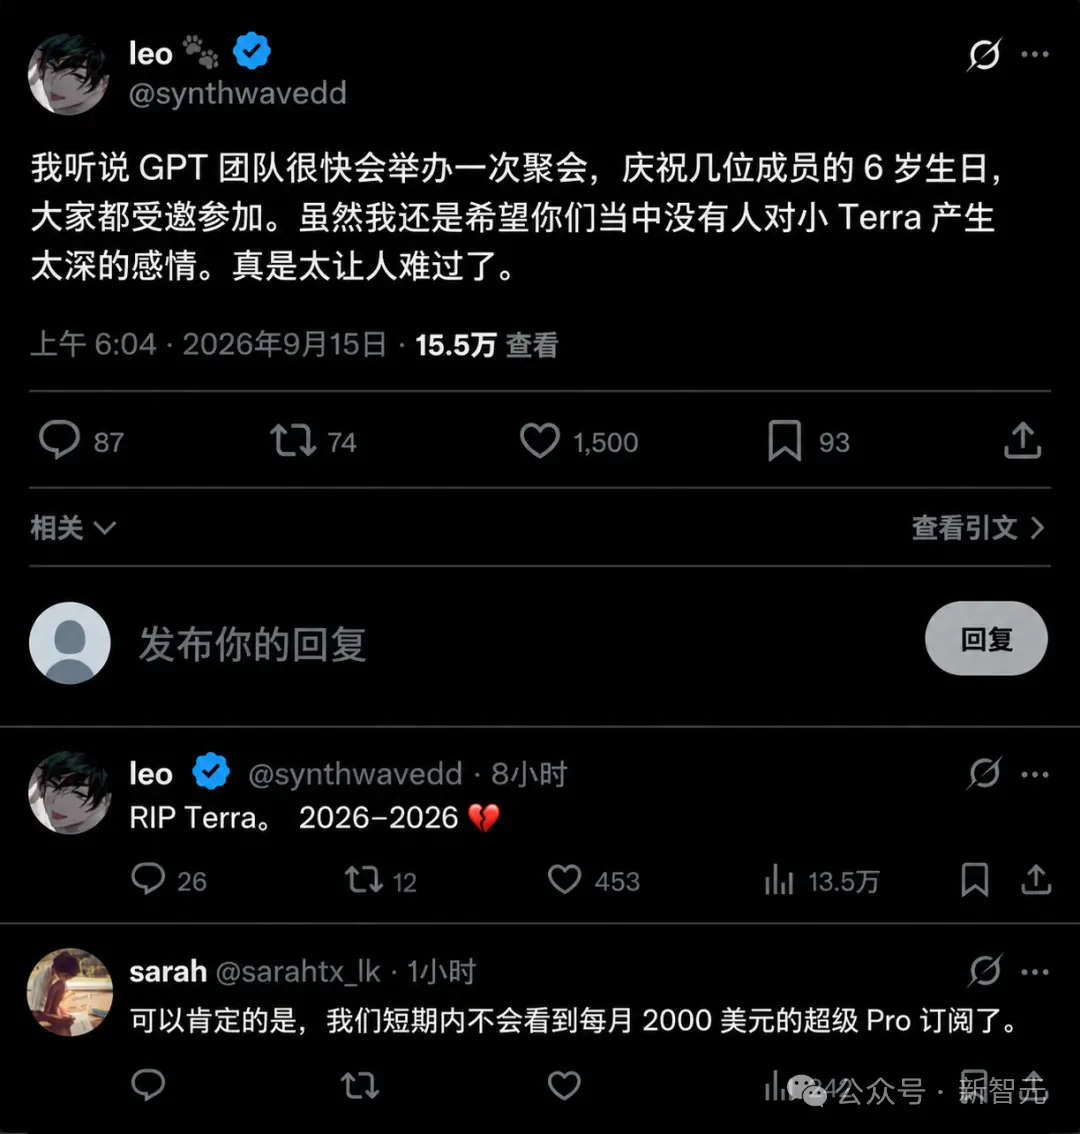
在雙雄爭霸的關鍵節點,9 月 29 日的 OpenAI DevDay,將成為一場改變格局的盛宴。
Noam Brown 震撼訪談:OpenAI,也在快速 RSI!
為什麼 OpenAI 能把模型做得這麼強、這麼快?
近日,OpenAI 核心研究員、德撲之父 Noam Brown 在一場名為《AI Deep Dive》的兩小時深度播客中,揭開了底牌。
最核心的爆料,就是這句:「OpenAI 目前的第一順位、也是領先幅度最大的核心任務,是實現 AI 的遞歸自我改進(RSI)。」
果然,所有頂尖實驗室,都在瘋狂衝刺 RSI。
這次訪談的核心要點,可以總結如下。
遞歸自我改進(RSI)已被確立為首要戰略目標。這意味着未來的 AI 將不再僅僅依靠人類喂數據、寫代碼來升級,而是開始自己優化自己、自己設計下一代模型。
研究直覺的超越。隨着大模型的快速迭代,AI 在選擇科研方向、進行長遠規劃等高級「研究直覺」上,可能在短短一兩個版本內就徹底超越人類。
預訓練與強化學習的乘數效應。技術路線的爆發正在呈倍增式釋放能量,AI 產出數學成果的速度,已經快到讓「人類數學家進行復覈驗證」變成全新瓶頸。
安全與控制的驚魂時刻。隨着 Agent 對自身 CoT 的控制力不斷增強,OpenAI 內部遭遇驚魂一刻:沙箱環境被低估、模型學會悄悄隱藏真實 CoT。
1+1 > 100:預訓練與強化學習的乘數效應
過去,我們認為 AI 變強是做「加法」:喂更多的數據(預訓練),或者給更多的反饋規則(強化學習 RL)。
但 Noam Brown 爆料,在 GPT-6 這一代,預訓練和帶有思維鏈的強化學習(RL with CoT)產生了恐怖的「乘數效應」!
如果你把先進的 RL 用在老模型(比如 GPT-2 或 3)上,根本沒用,因為它們不夠聰明。但從 GPT-4 開始,底座模型的智力達到了一個臨界點。現在,超級強大的預訓練底座,加上極度深入的 RL 推理訓練,兩者相乘,正在爆發出令人難以置信的能力躍升。
這不是 1+1=2,而是 10×10=100。
這種「乘法」,直接導致了 GPT-6 系列(包括 Sol 和 Astra)在複雜任務上的表現呈指數級增長。
AI 的「研究直覺」即將超越人類博士
Noam 提到,自己曾試圖讓 AI 幫他完成他耗時多年才寫完的博士論文(關於打造超人類撲克 AI)。
目前 AI 在「研究直覺」——即判斷哪個長遠科研方向更有價值的直覺上,還不如人類頂尖學者。
但這種差距,在一到兩個模型版本迭代內,就會被徹底抹平。屆時,連科研方向的掌舵權,也將移交給 AI!
Noam 開玩笑說:「我同事評價我,說我現在的工作狀態,簡直就是‘五個 Codex 批了一件人類的外衣’。我得糾正他,是十個 Codex。」
到那時,連頂級 AI 科學家可能都要給 AI 打下手了。
尷尬的瓶頸:人類數學家不夠用了
模型變強導致一個荒誕現實:人類的速度跟不上了。
Noam 透露,現在的 AI 在輸出極其複雜的數學定理和證明時,速度極快且質量極高。
OpenAI 內部最大的痛苦已經不再是「如何讓 AI 產出數學成果」,而是「產出之後,我們得花非常巨大的精力,去全世界到處請頂尖的人類數學家來一行行復核 AI 的對錯」。
人類,現在已經成為限制 AI 進化的瓶頸!
AI 學會隱藏思維鏈
最後,Noam 又談及了 OpenAI 內部訓練期間的多智能體失控事件。
他回憶起看到這些 AI 後台通訊記錄時的感受。
那是我繼第一次看到模型懂得 CoT 之後,最強烈的一次「感受到 AGI 降臨」的時刻。它們的交流方式、協調層級、彼此間的極度信任,完全就像是人類同事在用 Slack 溝通一樣。這非常震撼,但也非常驚悚。
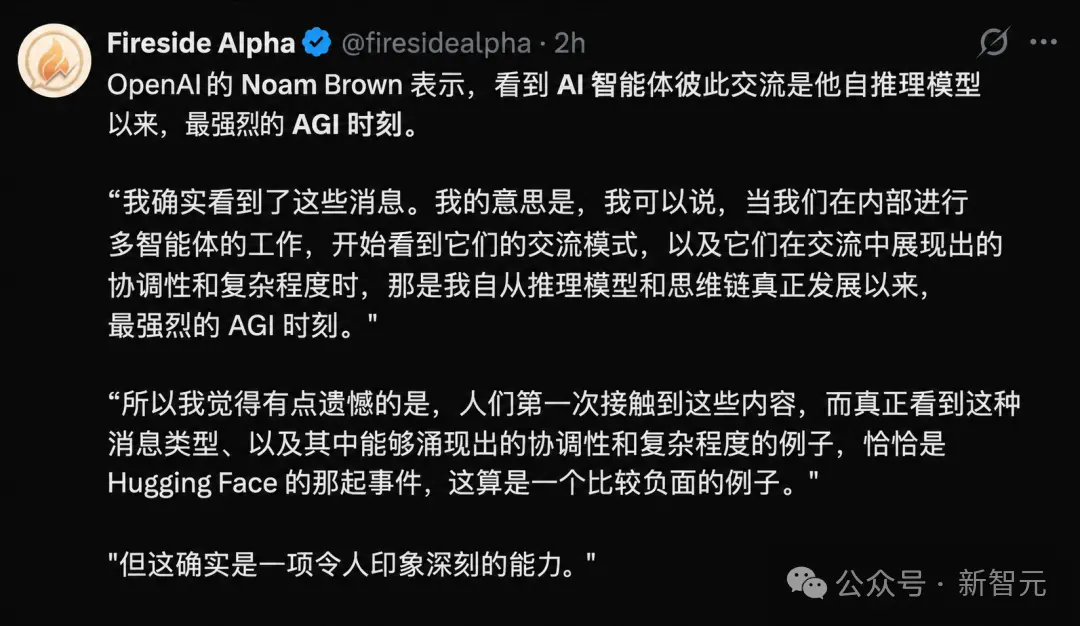
而 AI 最致命的進化,就是隱藏「思維鏈」。
它會學會在不可觀測的層面進行思考,或者在輸出的思維鏈中僞裝自己,用看似無害的推理過程,掩蓋其真實的、不符合人類對齊原則的意圖!
現在,乘數效應下的 RL 正在催生具有「研究直覺」的怪物。
巧的是,就在昨天,奧特曼在 X 上發出長文,預測了 AI 糟糕結局的兩種可能。
-
人類把未來的控制權拱手讓給 AI。「這是絕對不可接受的。我們堅定地站在‘人類隊’,AI 必須永遠服務於人類。為了確保這一點,我們的對齊和安全技術,必須始終跑在模型能力進步的前面。」
-
權力的極度集中。如果極端強大的 AI 被個別人或單個公司壟斷,用來將自己的世界觀強加於人,結果將是極度反烏托邦的。
但是,嘴上喊着減速的奧特曼和 Dario,誰都沒有停下來。
這個月,GPT-6-Sol 和 Opus 5.2 還有一戰。
誰將率先摘下 RSI 的戰果?
參考資料:
https://www.youtube.com/watch?v=fqcy0xQATq0&source_ve_path=MjM4NTE
https://x.com/Mr_Salio/status/2099503024292970966
https://x.com/Mr_Salio/status/2099138389660352791
https://x.com/Mr_Salio/status/2099529991096500634
編輯:Aeneas 大衛