機器人前瞻(公衆號:robot_pro)
作者 | 鍾宸
編輯 | 漠影
機器人前瞻9月16日報道,昨日,松延動力旗下通用具身智能子品牌Scalabot發布機器人模型HERON-Context Reinforcement Action Model(CRA)。
這是一種上下文—強化—行動機器人基礎模型(A Context-Reinforcement-Action Robot Foundation Model),也是HERON技術架構體系下的第二個模型(首個為9月8日發布的HERON-World Model)。
該公司指出,這一模型能讓機器人記住過去、從錯誤中學習,並將一次經驗轉化為下一次能力。
據官方介紹,HERON-CRA構建了三項關鍵能力,包括:
Cross-Embodiment Pretraining(跨本體預訓練基座模型):可在各類本體上快速完成後訓練與部署;
Context Expert(上下文專家):結合多模態能力,具備4D時空記憶能力;
極簡、可快速適配的強化學習(RL)引擎;
由此,松延動力認為,模型可讓機器人理解任務如何發生,從錯誤中持續修正,並將學到的能力跨越不同身體與任務進行遷移。
一、具備長時序記憶能力,可「矇眼」抓物
松延動力展示的視頻中,該模型完成了製作咖啡這一長程任務,包括接咖啡粉、把手柄放入壓粉底座、壓粉、裝手柄、鎖手柄、倒牛奶等操作,全程不到30秒。
HERON-CRA還實現了跨本體泛化,在放置咖啡杯和解鎖、取下並清洗萃取手柄等一系列操作中,松延動力分別使用了機械臂ARX和輪式人形機器人Noetix M1兩種形態的本體。不過,製作咖啡任務中的操作均由夾爪完成,且從視頻觀察,機械臂的操作穩定性似乎存在不足。
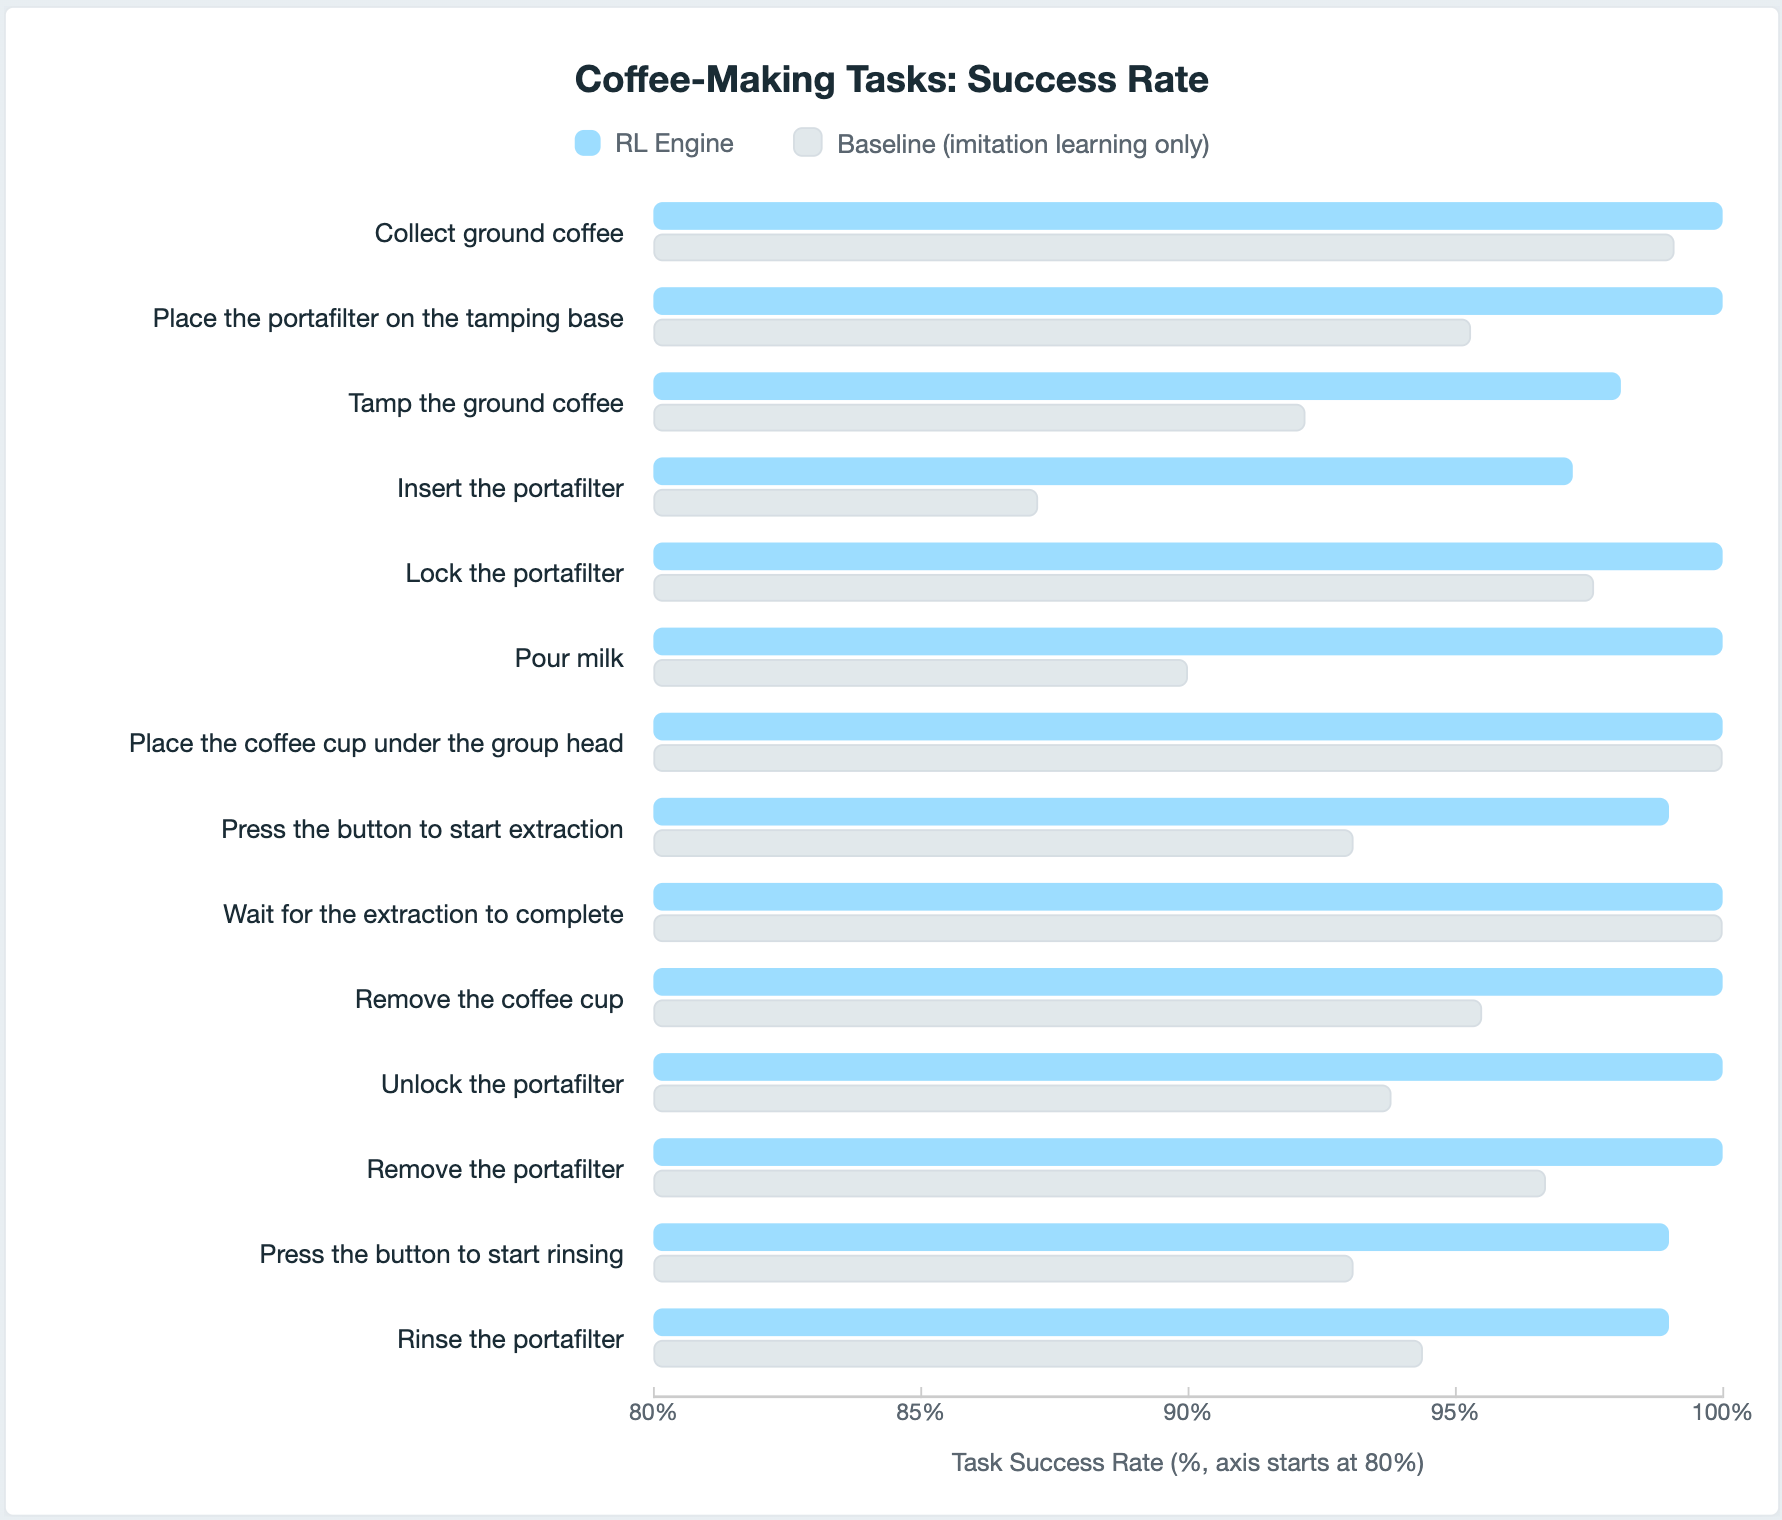
在咖啡製作任務的成功率上,松延動力將RL Engine與純模仿學習基線(Baseline,imitation learning only)做了對比。據官方圖表,RL Engine在多數環節上領先。
松延動力還表示,HERON-CRA具備從干擾中恢復的能力。視頻中,當人為將杯子拿開時,機械臂會追蹤杯子、嘗試抓取。
同時,基於跨本體預訓練,HERON-CRA在一定程度上具備物體與位置的泛化能力。松延動力透露,模型經少量數據後訓練,即可抓取任意桌面上任意位置的物品。
從視頻來看,該模型可以抓取不同物品,在人為干擾下也能較快調整;即使在運行中途用黑布遮擋部分視覺信號,操作仍能繼續執行,一定程度上體現了HERON-CRA對視覺輸入缺失的魯棒性。
另外,HERON-CRA還可以完成靈巧操作,如把芹菜、黃瓜切段,秋葵去蒂;不過視頻中切段的長度並不均勻。
該模型還可以完成柔性物體的精細操作:機械臂能疊放、捲曲襪子,也能識別不同顏色的襪子完成同一操作,但耗時較長,整個流程超過一分鐘。
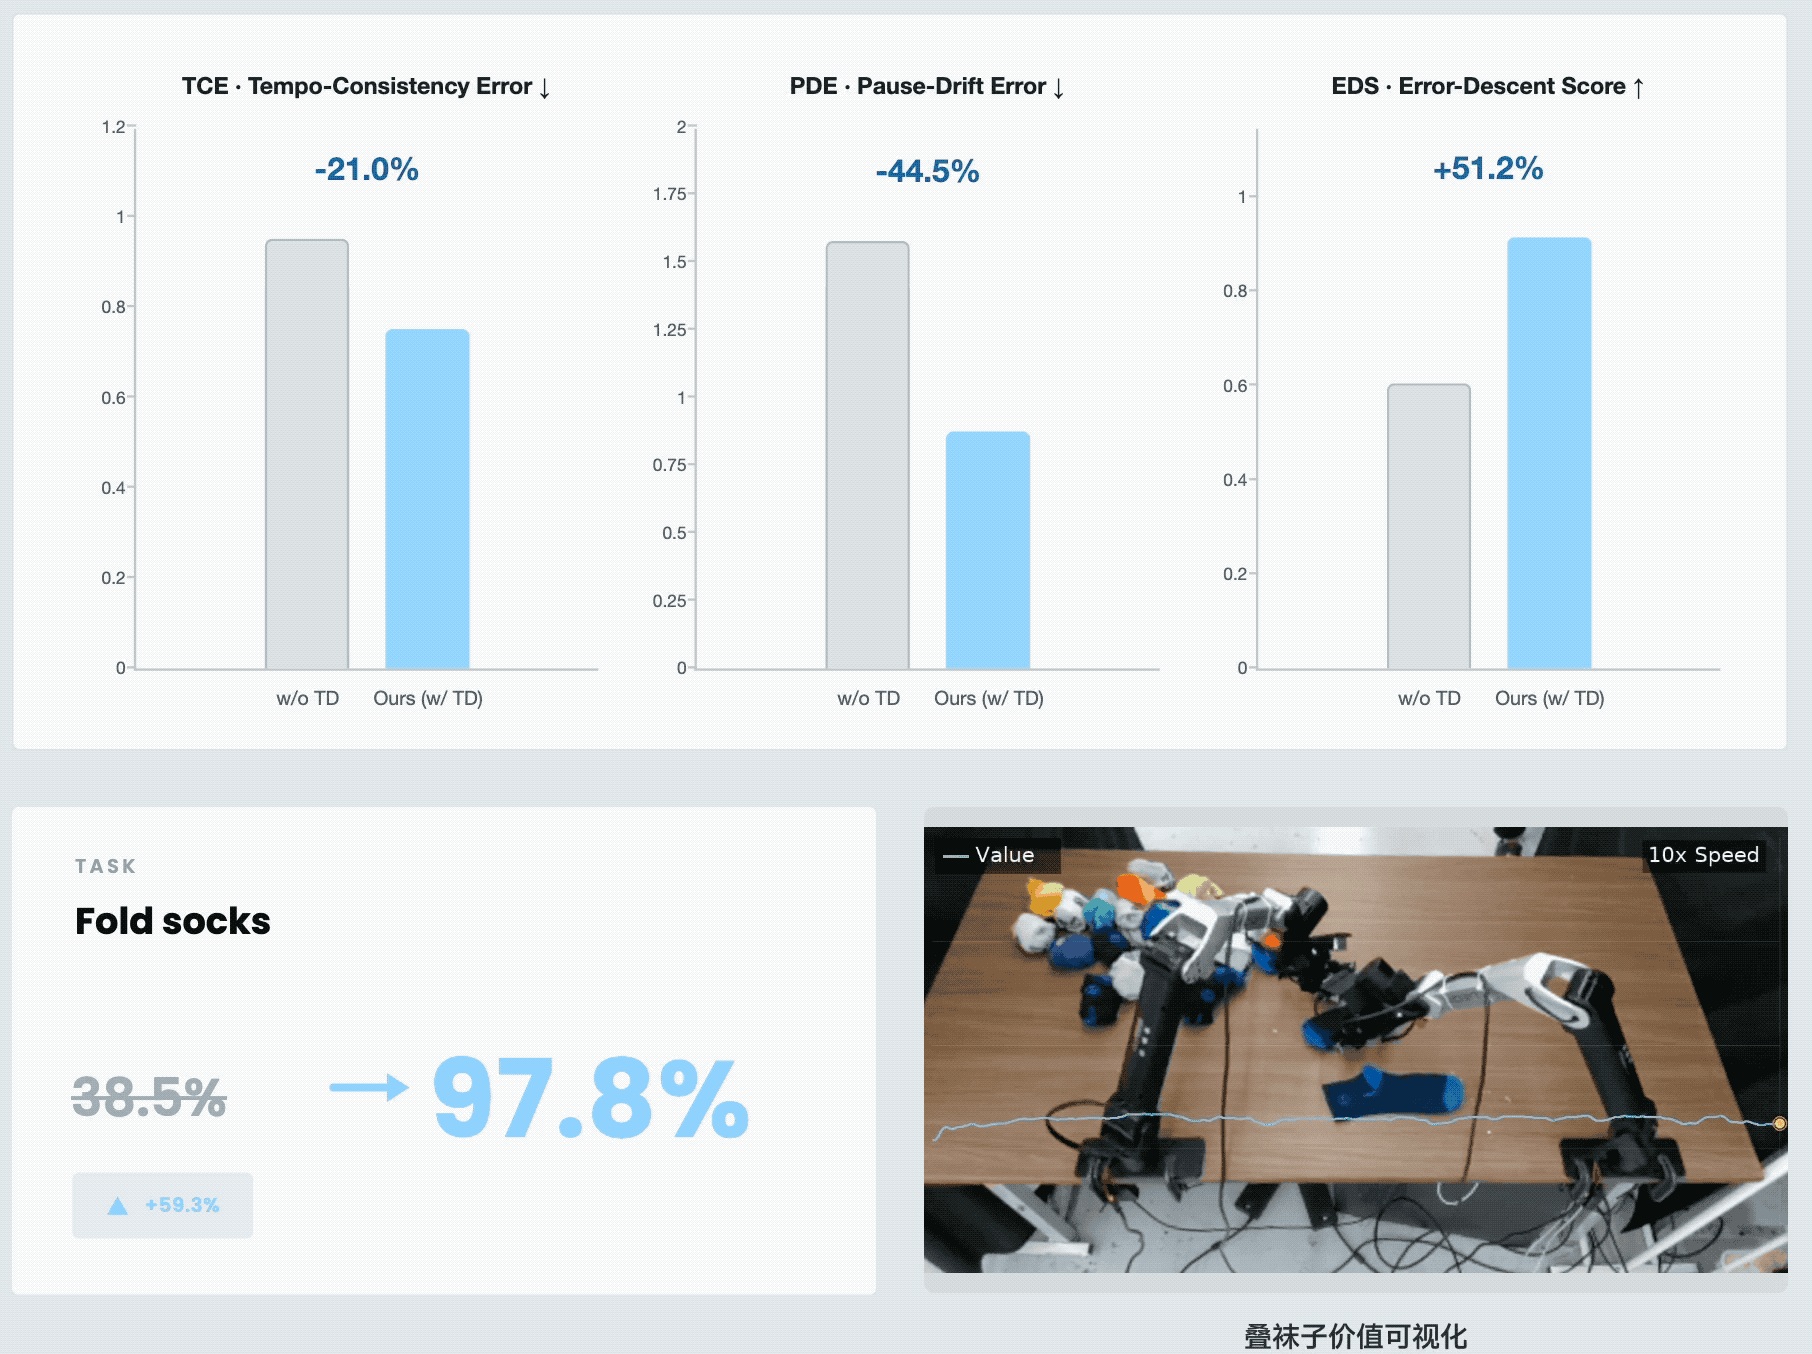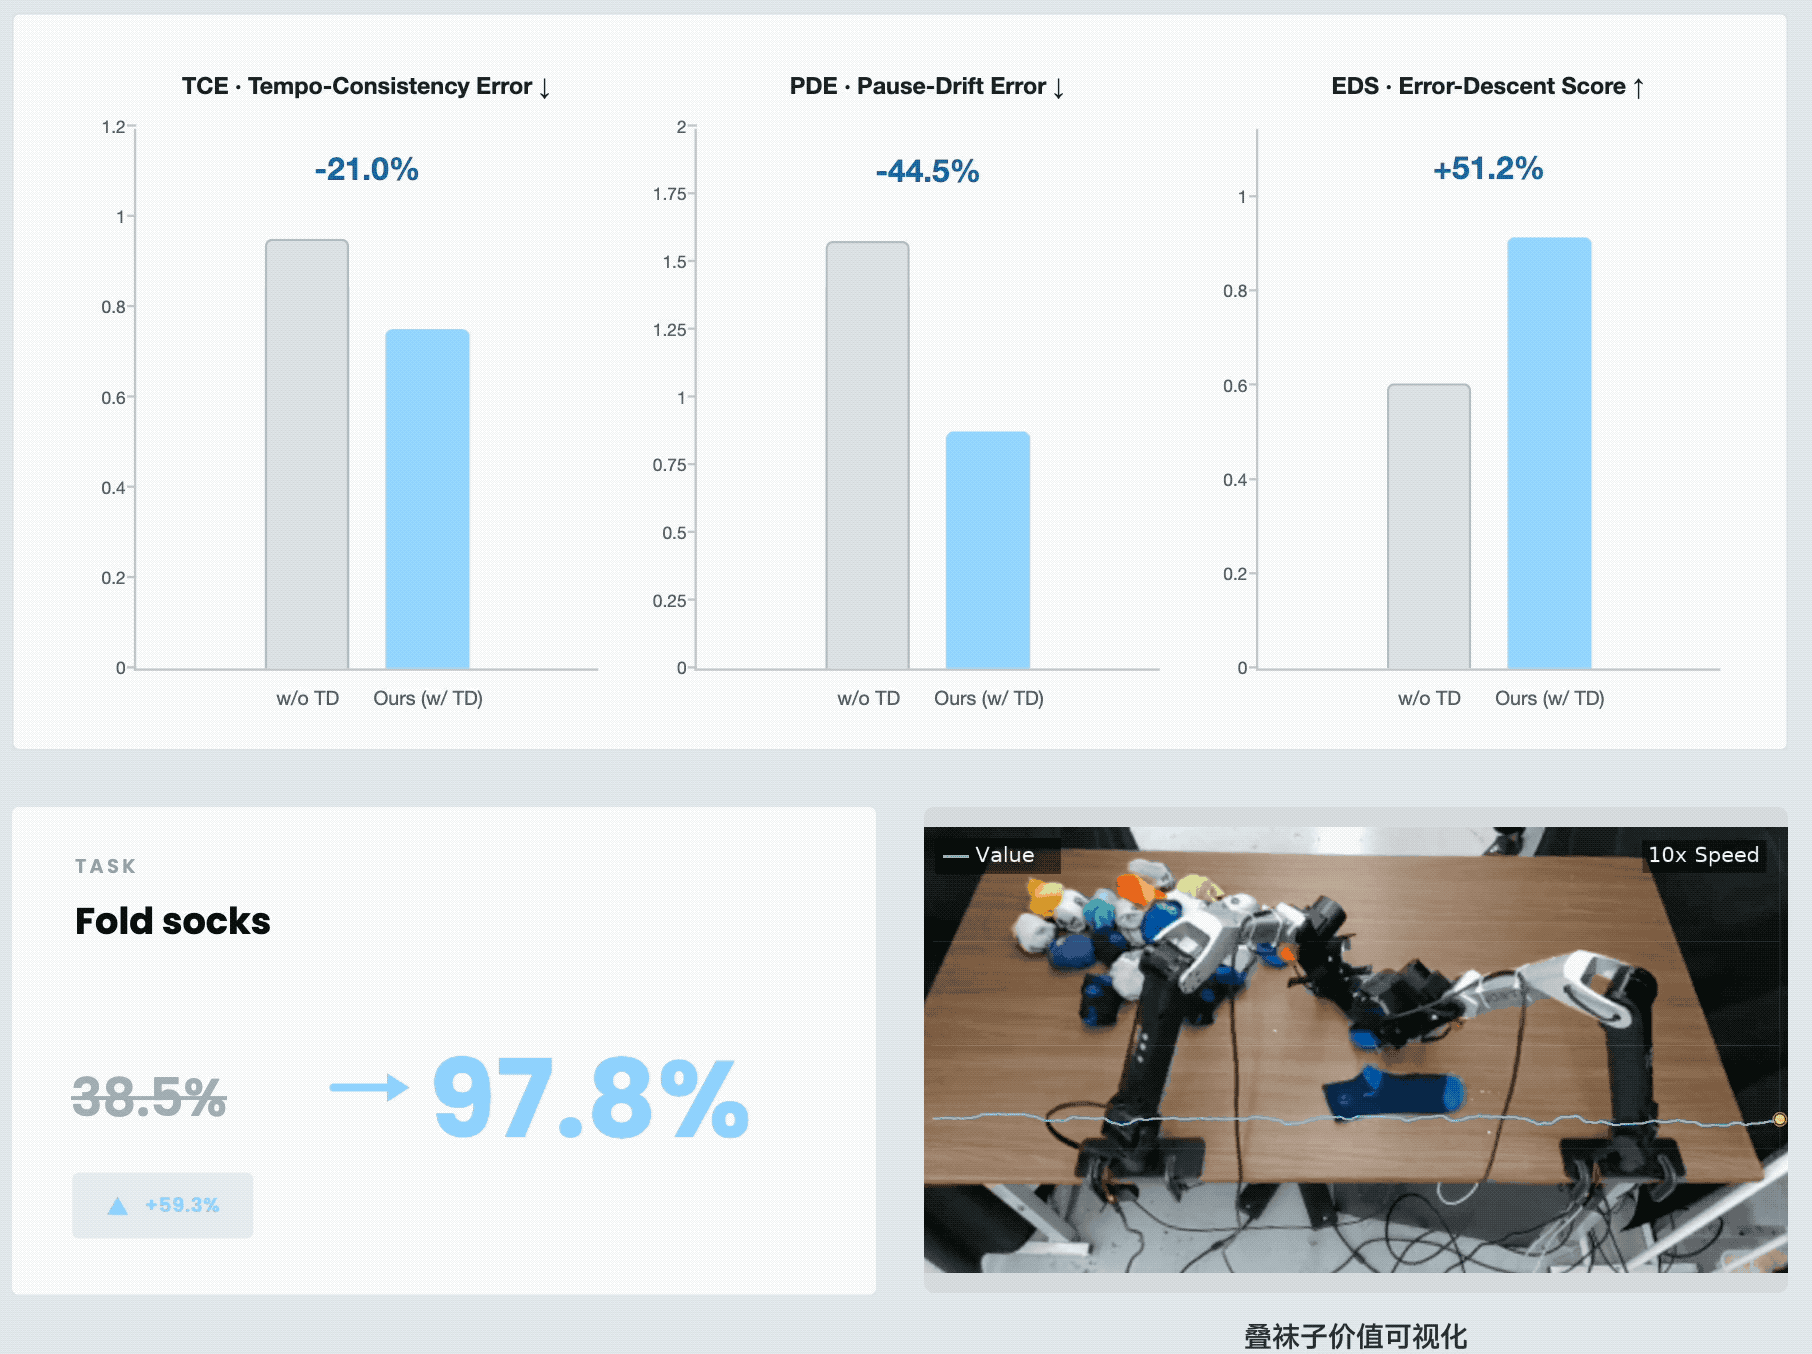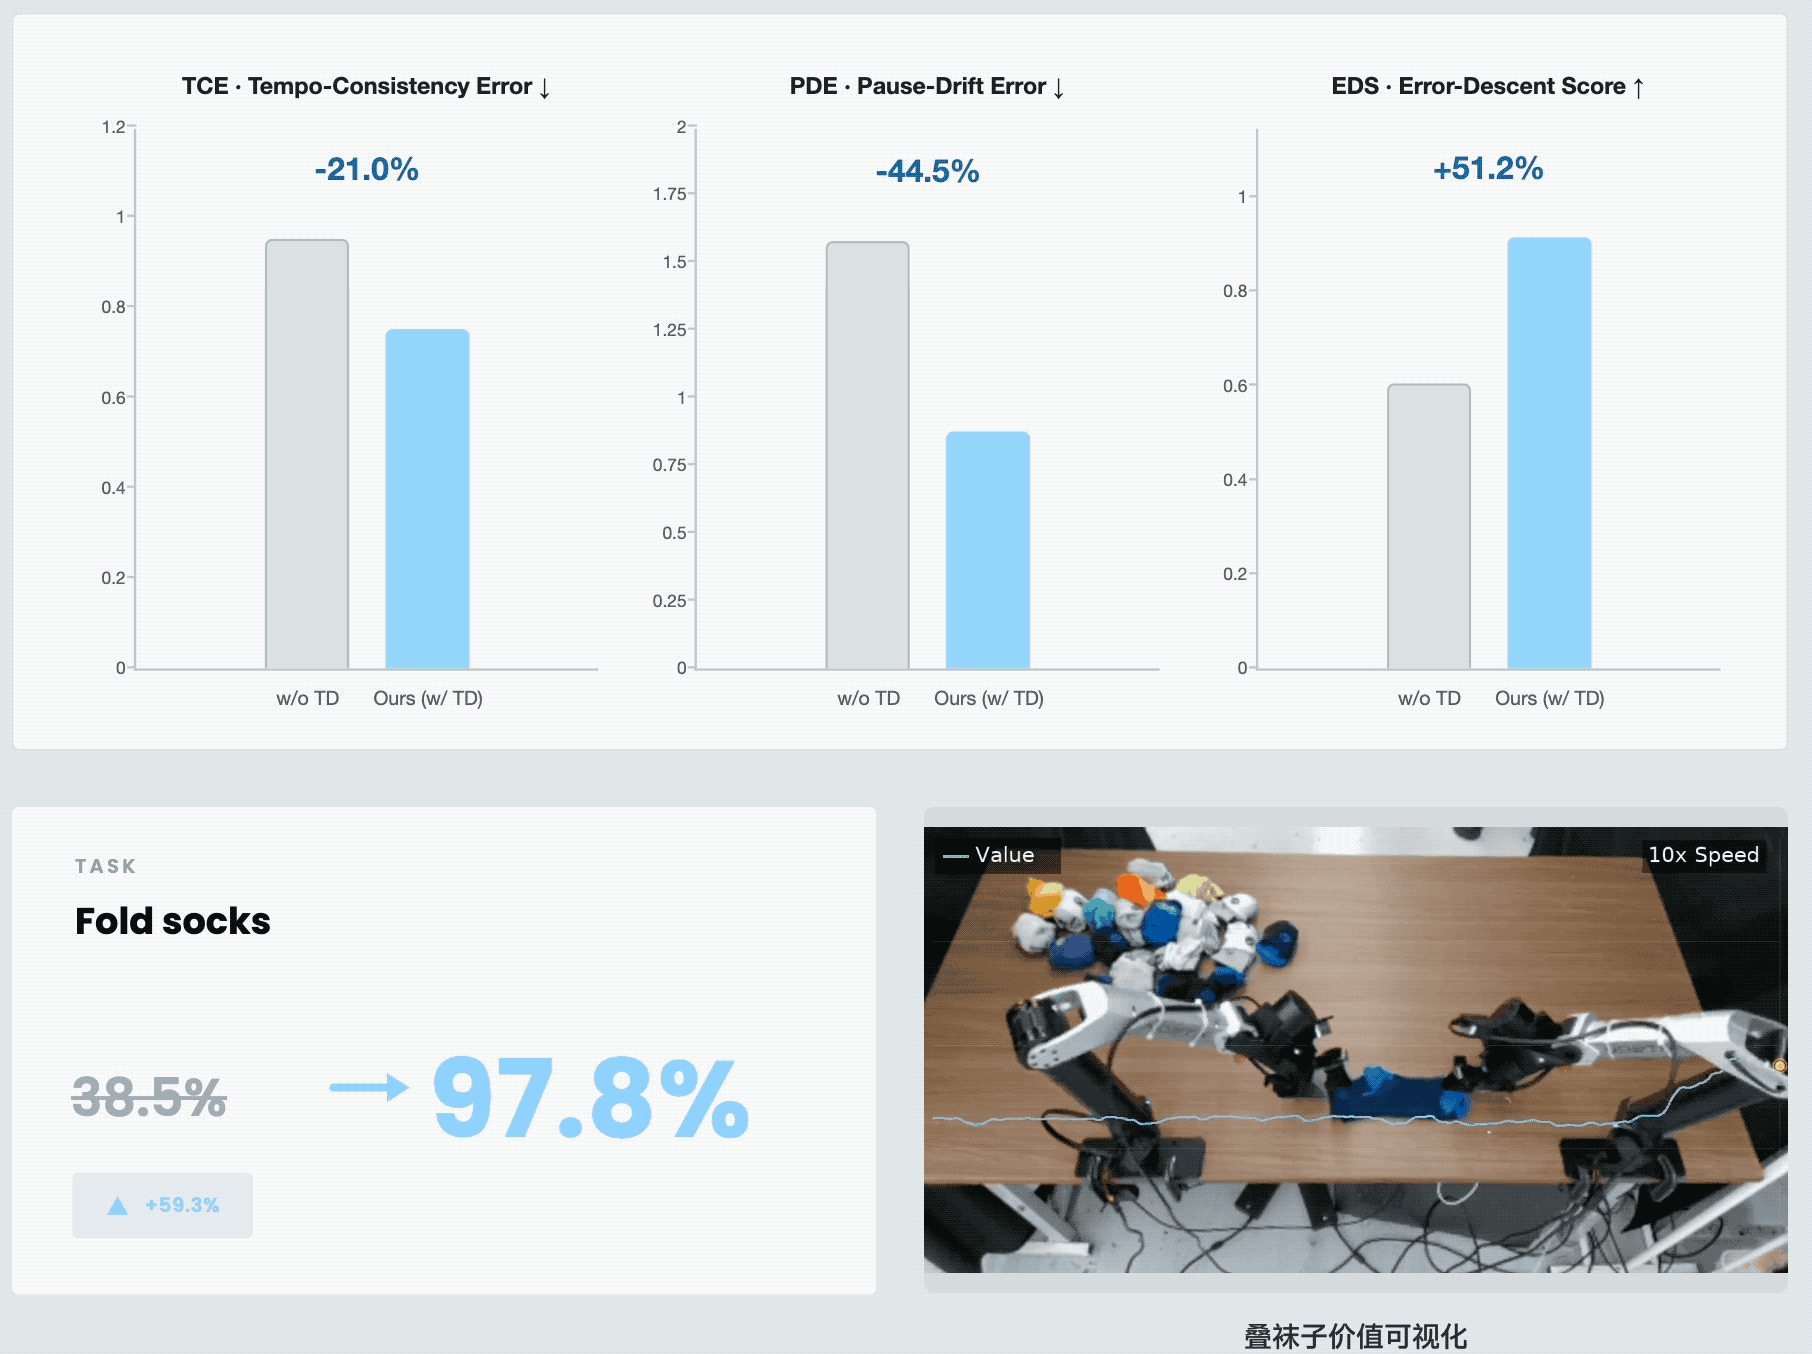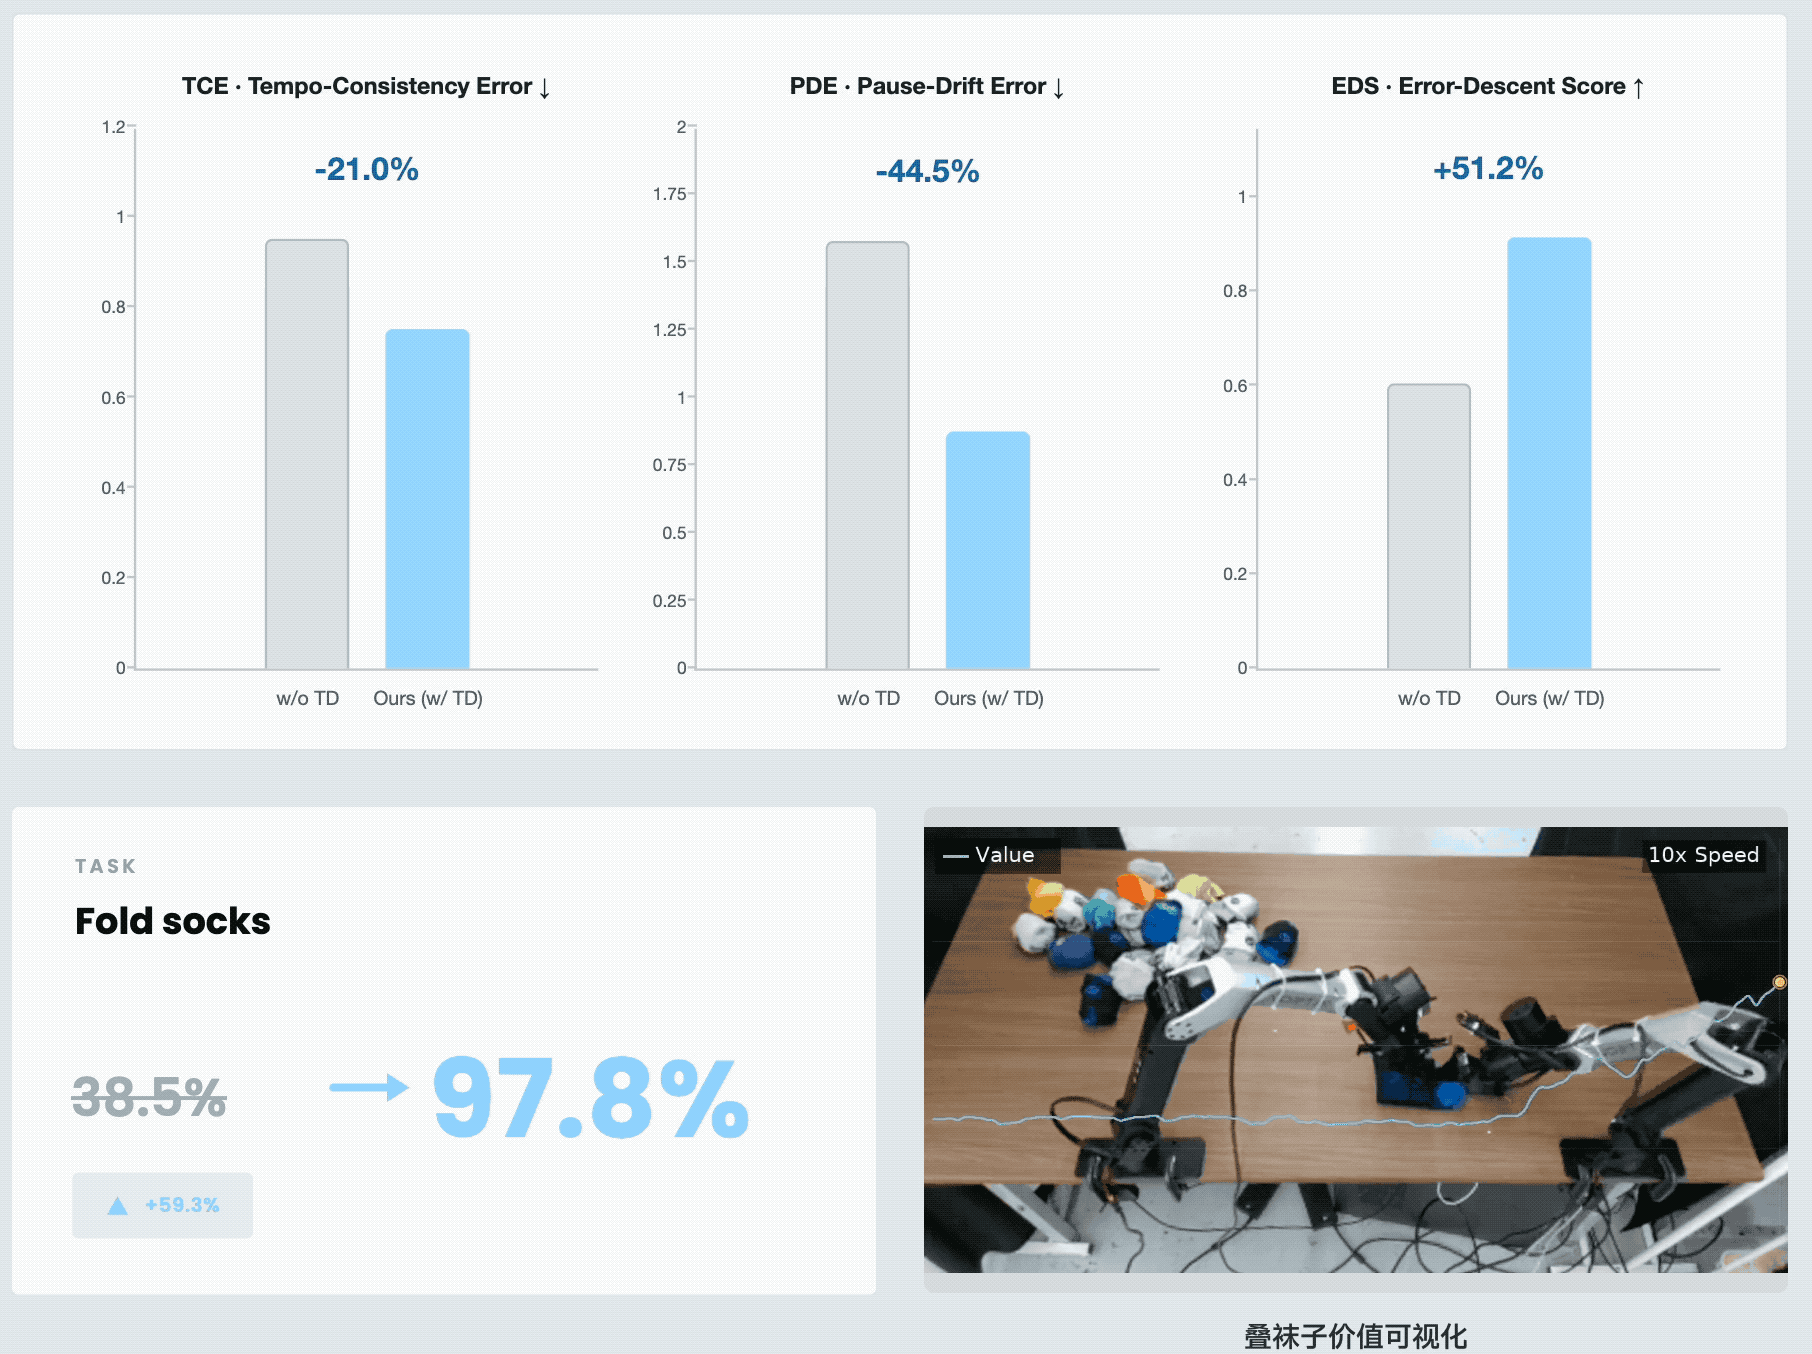
在此項任務上,松延動力指出,僅模仿學習的基座成功率為38.5%,而開啓RL Engine後,成功率提升至97.8%。該公司還對時序魯棒性和失敗敏感性提升做了定量檢驗,HERON-CRA在三項指標上佔優,即擾動下讀數波動更小,真實出錯時讀數下降更早、更充分。
(注:松延動力稱,時序魯棒性由變速一致性TCE(Tempo-Consistency Error)與暫停漂移衡量PDE(Pause-Drift Error),TCE和PDE越低越好,失敗敏感性由錯誤階段下降響應衡量EDS(Error-Descent Score),EDS越高越好)
HERON-CRA還具備長時序記憶能力,目前可支持超過1分鐘的記憶時長。視頻演示了20次以上的杯子調換,該模型均成功猜中球所在的杯子。
給定一段記憶並配合相應的語言指令,HERON-CRA便能跟隨指令完成任務,即單次示範學習(In-Context Learning)。
松延動力還展示了HERON-CRA更進一步的記憶能力:在長時序記憶與單次示範學習的配合下,該模型能把被人為弄亂的三個玩具放回原位。
二、提出三項關鍵能力,未來將進一步驗證
圍繞讓機器人能夠記住過去、從錯誤中學習,並將一次經驗轉化為下一次能力這一目標,松延動力稱,HERON-CRA構建了Context Expert(上下文專家)、RL Engine(強化學習引擎)與Cross-Embodiment Pretraining(跨本體預訓練基座模型)三項關鍵能力,即讓機器人理解任務如何發生,從錯誤中持續修正,並將學到的能力跨越不同身體與任務進行遷移。
具體來看,Context Expert將記憶能力與物理建模能力相結合,把帶有時序信息的4D壓縮token接入Transformer進行訓練。
松延動力表示,這一方式使模型具備了場景中的空間歷史記憶能力,並展現出基於長時序上下文的快速學習能力(In-Context Learning)。
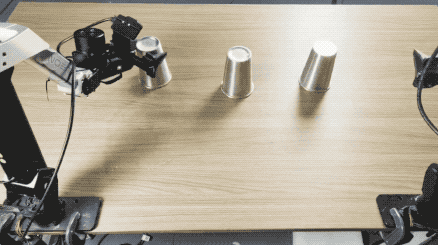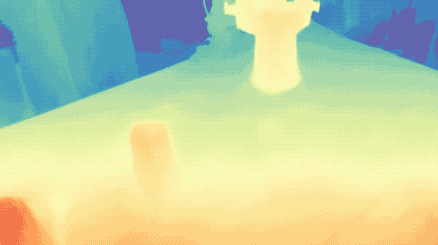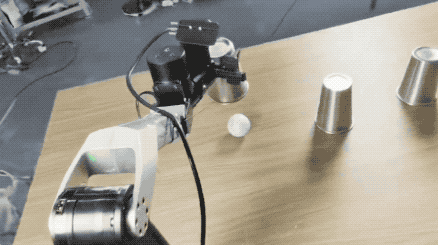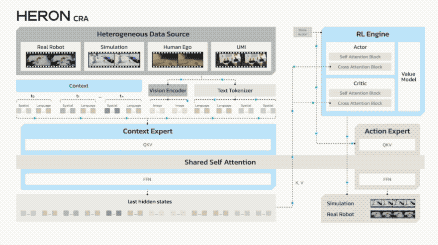
在松延動力的技術博客中,這一實現過程被詳細拆解:首先,Context信息由空間token與語言指令token沿時間維度拼接而成,語言指令的接入確保模型習得對歷史多任務變化的認知。
隨後,Context信息再與當前圖像及語言指令token拼接,一併送入Context Expert訓練;Context Expert與Action Expert則以Mixture of Transformers(MoT)的形式聯合學習。
由此,Context Expert在學習時空信息的同時,也保留了VLM對圖像的理解能力;其蘊含多維信息的K、V參數則共享給RL Engine,用於後續訓練。
在強化學習引擎層面,松延動力認為應圍繞兩個目標構建:其一是獎勵可靠、可擴展,其二是訓練框架極簡、統一。
基於此,松延動力設計了一套RL Engine:價值模型(Value Model)負責提供稠密、穩定的獎勵信號,具備時空感知的策略網絡與HERON-World Model共同支撐離線與在線訓練。
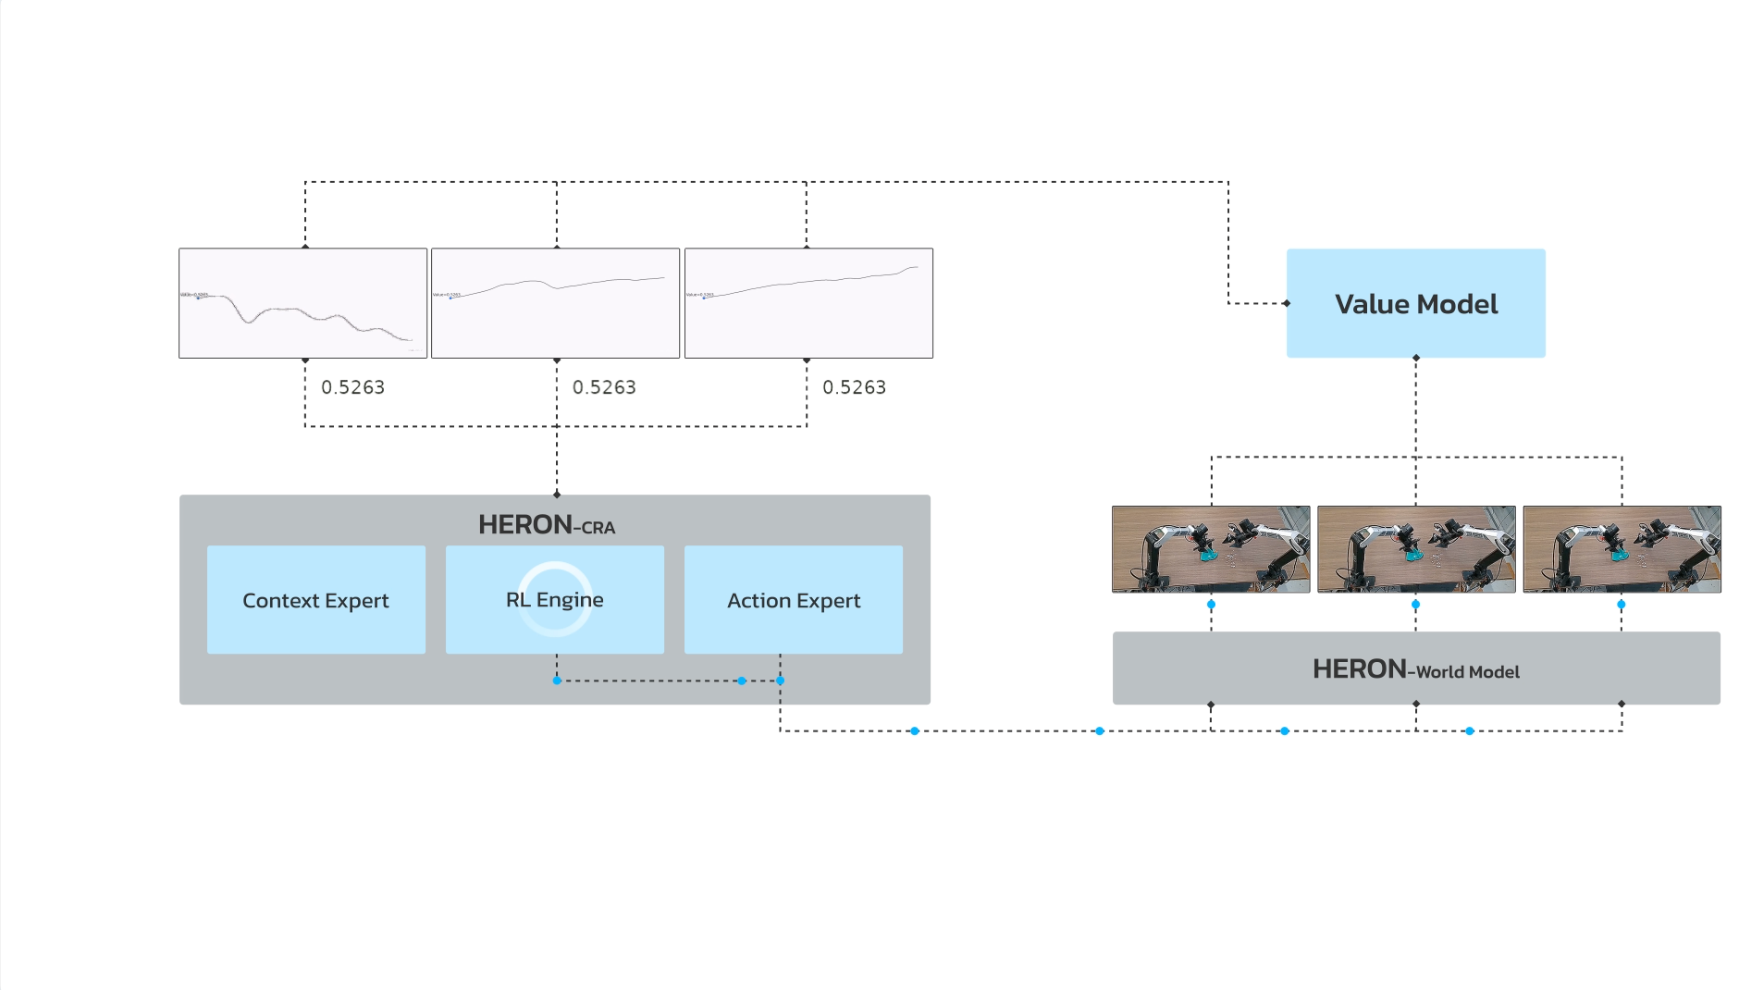
松延動力指出,這樣的設計使RL Engine與基座模型解耦,可實現即插即用。
但在構建中,松延動力在價值模型層面遇到了兩大問題:失敗數據缺失,以及逐幀迴歸缺乏時序一致性約束。
松延動力的解決辦法是,將價值錨定在任務結果上,並引入時間差分(Temporal Difference,TD)約束以規整整條價值曲線,軌跡終點由任務的最終結果定價,中間每一幀的價值被下一幀價值約束;結果信息由此沿軌跡反向回傳,逐幀修正價值估計。
由於僅依賴真實數據時樣本效率較低,該公司又引入了基於HERON-World Model的數據Rollout,從真實數據中採樣狀態作為起點,讓策略在世界模型中執行一段動作序列,生成對未來的視頻預測。
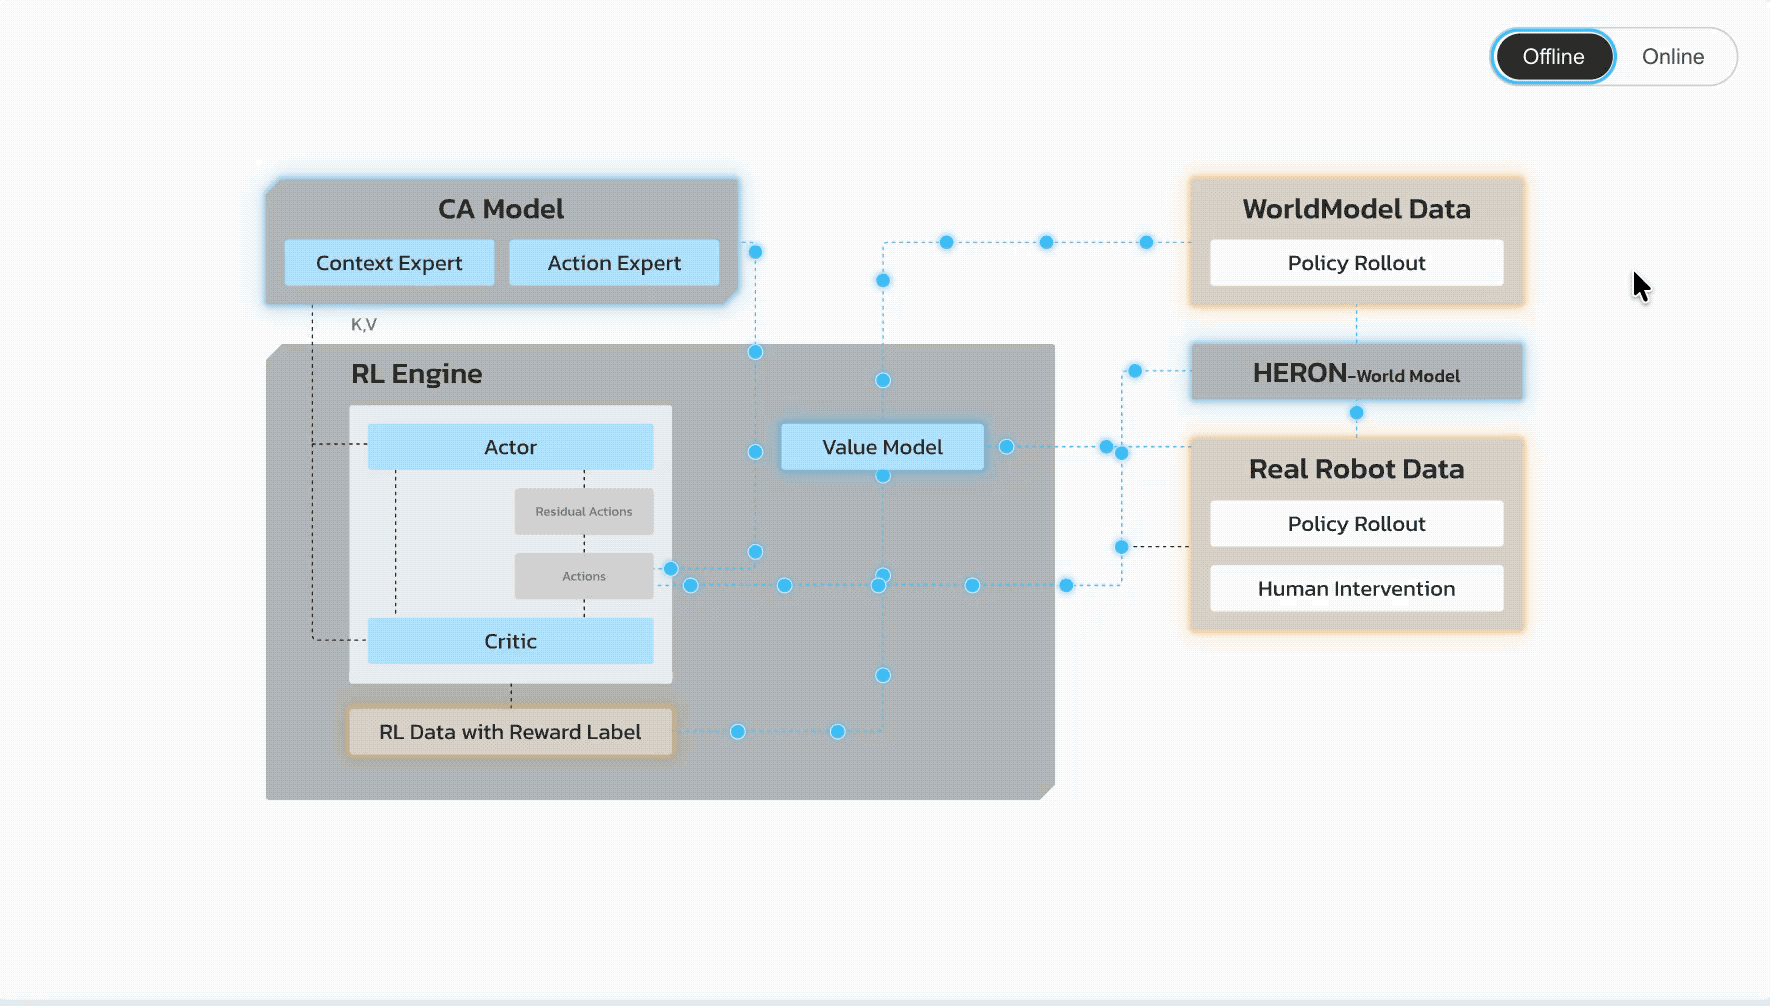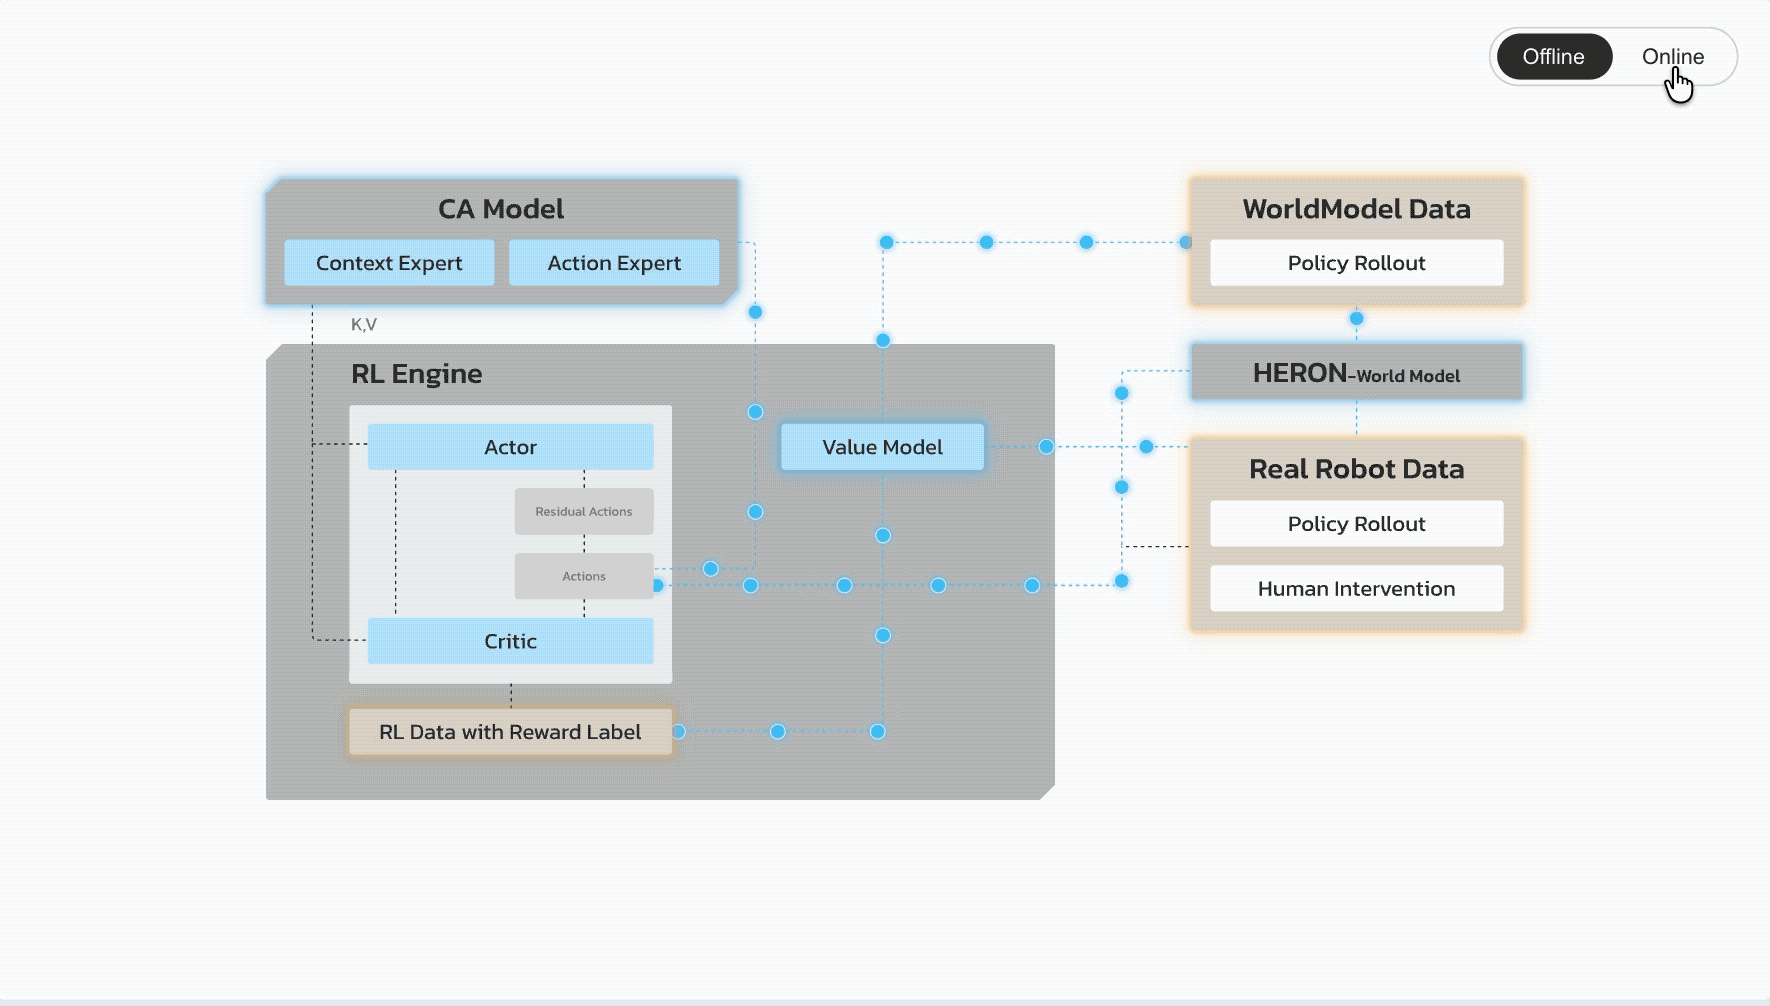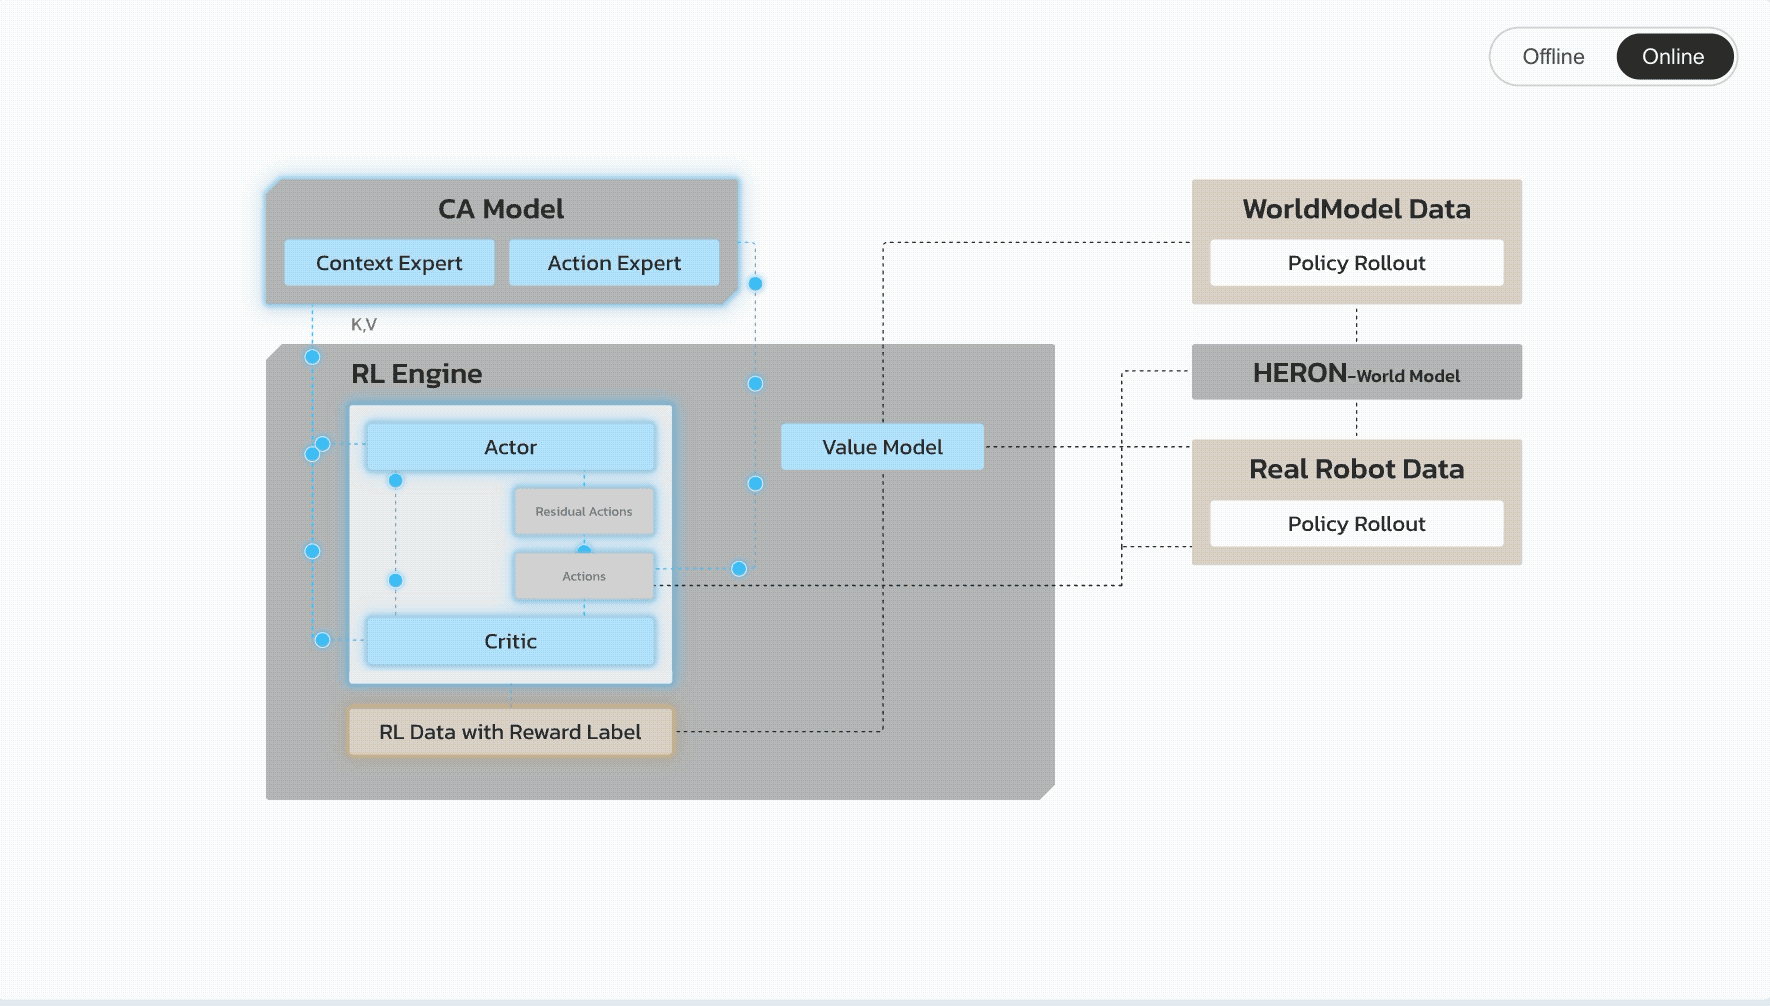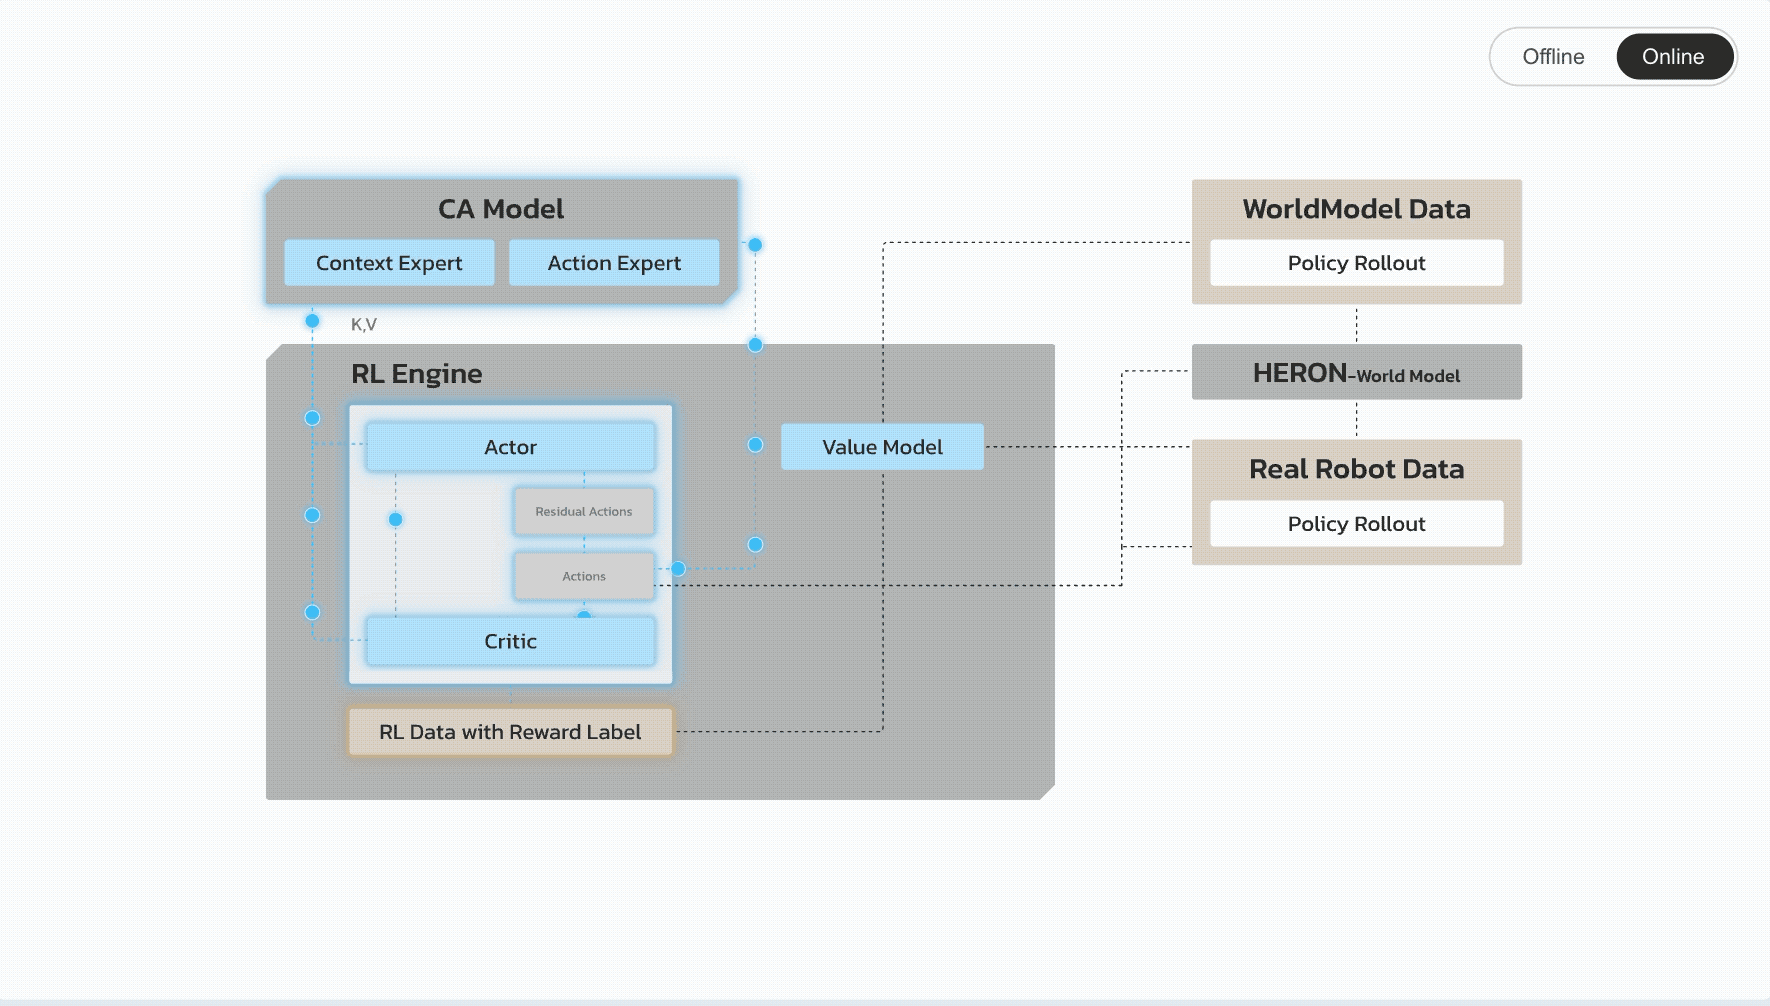
RL Engine還可以用同一套組件支持離線學習與在線學習。
如圖所示,該引擎採用Actor-Critic架構,通過交叉注意力複用凍結的高信息密度多模態Context Expert的KV值:Actor預測動作殘差,用於修正Action Expert的輸出;Critic評估動作價值,以指導Actor的更新。訓練全程僅更新Actor-Critic,其餘模塊保持凍結。
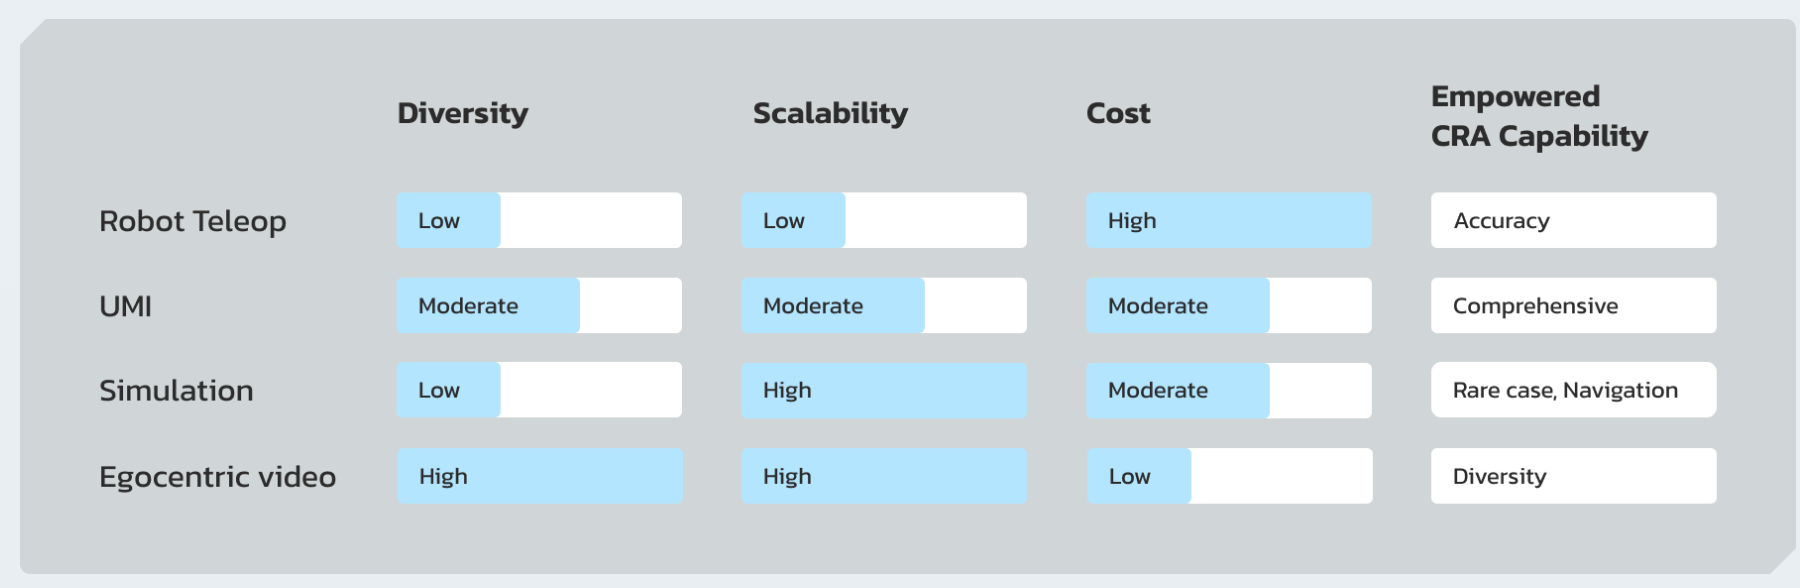
而在預訓練數據上,松延動力認為,機器人數據來源不可避免要在多個維度之間做出權衡。
至於預訓練階段的目標,松延動力主張讓基座模型學會的是對物理世界的理解,而非動作的執行,監督信號應當是真實的物理規律,而非僅有機械臂關節角度、末端位姿這類低維信號。
為此,在預訓練過程中,其採用學習時空物理規律的方法,以物理規律為目標對模型進行監督學習,讓模型在物理世界中建立起認知,同時聯合監督機器人動作信號。
松延動力還透露了下一步計劃,將在預訓練模型之上進一步驗證以下內容:
第一,檢驗預訓練是否進一步提升了In-Context Learning與few-shot能力;同時,RL Engine兼具的Test-Time-Training(TTT)功能也將同步開展測試。
第二,聚焦預訓練模型的落地應用:將模型部署到真實世界,把速度與成功率推高。
此外,松延動力指出,HERON-CRA與HERON-World Model目前主要聚焦上肢操作,後續將探索把HERON系列擴展至人形機器人的全身操作能力。
結語:組合有效,但下一步是走向現實場景
HERON-CRA的思路,是把」記住過去、從錯誤中學」拆成三個可組合的模塊:跨本體預訓練打底,Context Expert管記憶,RL Engine管糾錯。
從演示看,這套組合是有效的:「矇眼」抓物、猜球、單次示範學習都成功了,疊襪子成功率也從38.5%提升至97.8%。
但官方視頻也留下了問號:機械臂操作不穩、切段不均、疊襪耗時一分多鐘,跨本體的效果更多是「能完成」而非「完成得好」。
記憶和糾錯的價值終究要回到真實場景裏檢驗,這正是松延動力自己列出的下一步,也是這篇技術博客還沒回答的部分。
技術博客:https://scalabot.noetixrobotics.com/blog/cra