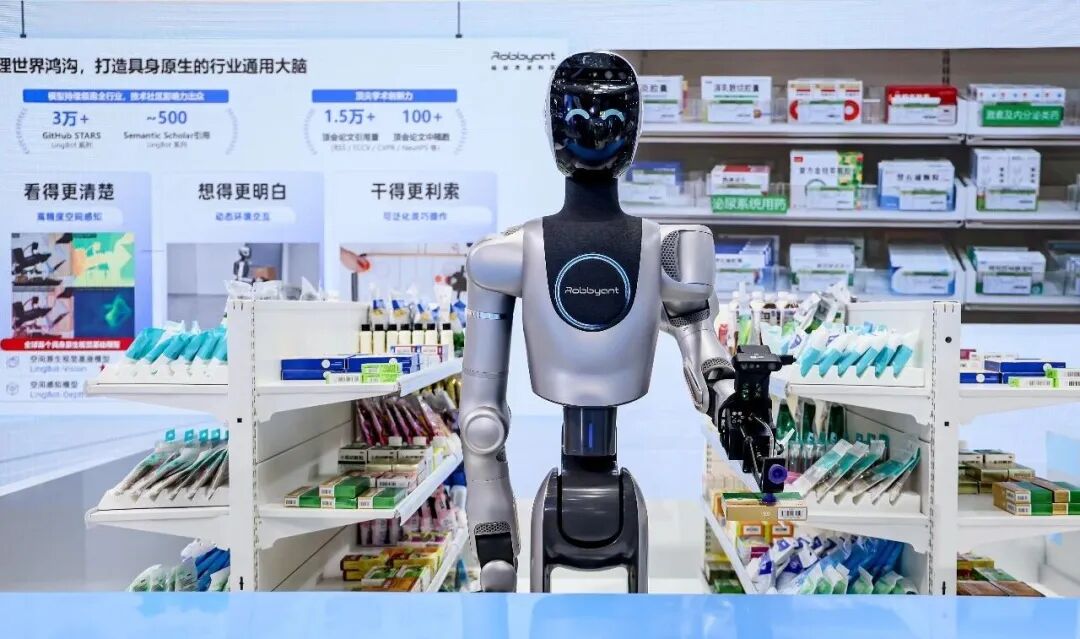
今年 9 月,一批金色的 Cybercab 開始在美國得州奧斯汀街頭提供付費服務。
相比於汽車行業,這件事對機器人行業的意義更大:一個由 AI 感知、決策並作用於現實世界的機器,開始執行可以直接計價的商業任務。
這恰好印證了 Andrej Karpathy 在特斯拉負責 AI 時說的一句話:汽車本來就是機器人,Tesla 本質上是一家「robotics at scale」的公司。
過去,人們習慣用外形來理解機器人:雙足、人形、機械臂。而一旦以外形來定義機器人,人們對它商業場景的想象也很容易隨之變窄。
當 AI 開始接管感知、決策和控制之後,僅憑外形,已經很難判斷一台機器的真實商業價值。讓它完成任務的,是它體內那套能感知、會決策、並驅動身體完成任務的智能系統。行業裏更願意把它叫作「大腦」。
當同一套「大腦」可以持續控制成千上萬台機器,在真實場景中完成任務、積累數據,並讓第三方基於它部署業務,公司出售的就不再只是某種硬件,而開始接近一種物理世界的智能基礎設施。
行業其實已經演示過一遍這種公司長什麼樣——操作系統、雲、大語言模型的 API,都是「一次投入、多方複用」的結構。
由此,一個比「誰能造出最好的機器人」更重要的問題浮出水面:到底什麼樣的公司,最終有機會成為具身智能的平台型企業?
2026 年的中國是回答這個問題的合適地點。隨着宇樹等具身智能廠商相繼啓動或完成上市,這條賽道正式交由二級市場定價。身處其中的玩家,在資本的聚光燈下,因生態位的差異,各自走到了截然不同的十字路口。
9 月 11 日,啓動獨立孖展後的螞蟻靈波 CEO 朱興首次公開露面,把這個問題的一部分答案推向台前;答案的另一部分,則散落在外灘大會的展區、合作伙伴和真實場景之中。
把台上台下的這些碎片拼在一起,一條平台化的路徑正在逐漸變得清晰:螞蟻靈波想做的,並不是再造一台屬於自己的機器人,而是成為更多廣義機器人背後的那顆「通用大腦」。
站在具身智能十字路口,該向哪側看?
當具身智能從技術演示走向商業部署,不同生態位的公司,正在望向不同的「北極星」。
獨立具身大腦公司追求的是複用率。Skild AI、Physical Intelligence、Generalist AI、FieldAI都在嘗試讓一套智能跨機器人、跨任務反覆使用。今年 1 月,Skild AI 完成 14 億美元新一輪孖展,估值超過 140 億美元;Physical Intelligence 在 2026 年5 月最新一輪孖展約10.5 億美元,估值約 112 億美元。資本已經願意為獨立於整機的智能能力定價。
具身本體公司看到的是出貨量。Figure、1X、宇樹首先要解決製造、成本和供應鏈,但也在加速補「大腦」——Figure 在 2025 年結束與 OpenAI 的合作後自研了 Helix;宇樹招股書顯示,其 IPO 募資 42.02 億元中,約 48% 投向了模型研發。
第三類玩家是場景方,他們不關心模型是誰的,只覈算部署成本、工作量替代、故障率和回本周期,北極星是單點 ROI。
三股力量之間存在真實的張力,平台機會就誕生於此。真實場景裏,機械臂、移動底盤、人形機器人往往同時存在,場景方希望一套智能能跨硬件遷移、持續降低部署成本;本體公司面對一個經典的「自建還是採購」問題,具身基礎模型的預訓練投入巨大,每家本體廠都自己付一遍,整個產業的效率會很低;而對具身基礎模型來說,接入的機器人越多,軟件邊際成本越低,迴流的物理數據又反過來抬高泛化能力。
把智能從單一本體裏抽離出來、成為跨硬件複用的基礎層——這就是獨立「大腦公司」的位置。它成立的前提是一個可以被驗證的經濟學命題:隨着接入的本體和場景增加,把模型適配到下一台機器、下一個場景的邊際成本必須持續下降。 做不到這一點,「大腦公司」就只是一家項目制的算法外包商。
那麼,什麼決定這個邊際成本下降?沿着全球頭部公司的路線,有五個槓桿:
第一,大規模自主預訓練。這決定了能力的起點。
第二,數據管線與 Infra。迴流的數據能否真正變成模型能力,而不是堆在硬盤裏。
第三,跨構型的模型設計。決定同一套模型能覆蓋多寬的硬件形態。
第四,全棧的工具鏈。決定合作伙伴用起來的門檻有多低。
第五,外部採用。前四項是否成立,最終要用第三方願不願意把自己的機器人交給這套模型來檢驗。
這五項能力並不是並列的:大規模自主預訓練是核心;數據管線與 Infra 是根;跨構型決定能力能否複用;工具鏈決定複用的門檻;外部採用是市場的判決。
沿着這五把尺子看中國市場,候選者不少,但同時在預訓練、數據體系、模型設計和工具鏈上持續投入,並已進入外部本體和真實商業場景的公司並不多,螞蟻靈波無疑是解析價值最高的樣本之一。
長線者手裏的籌碼
要拆解螞蟻靈波,方式或許有一萬種。過去一年,這家公司在數據、模型、架構和場景上鋪開的東西已經足夠多。相比逐項羅列技術名詞,從一次真實的產業選擇切進去,可能更容易看清這些能力之間的關係。
這個選擇來自樂聚,開發 KUAVO-VLA 時,樂聚最終選擇 LingBot-VLA 2.0 作為通用基座。樂聚從機器人本體和小腦控制起家,隨後延伸到數據和垂域模型,本身具備模型研發能力——這讓它的選擇更值得追問。
樂聚機器人聯合創始人兼 CEO 常琳在外灘大會上提到,雙方團隊「融合程度非常高」;螞蟻靈波 CEO朱興則形容,靈波把基模和工具鏈交給樂聚,同時也持續吸收樂聚在本體和場景側的輸入。
一家已經擁有本體、數據和算法能力的機器人公司,為什麼仍然選擇建立在LingBot這個基座上?
答案的第一層,是大規模預訓練的門檻。螞蟻靈波科技首席科學家沈宇軍在外灘大會上專門提到,從零到一開發基模,與基於已有模型繼續微調,需要的是兩套不同的能力——難點不只在模型結構,還包括能否把大規模數據穩定運行在大規模算力上,並持續產出可迭代的模型。
朱興也多次把預訓練看作基座公司的重要分水嶺。回看大語言模型的發展,最終留在「主桌」上的玩家,都經歷了從零預訓練的高投入和高風險;在別人模型上做微調的公司,很少能形成獨立的議價權。具身智能進入「百模大戰」後,類似的分化也正在出現。
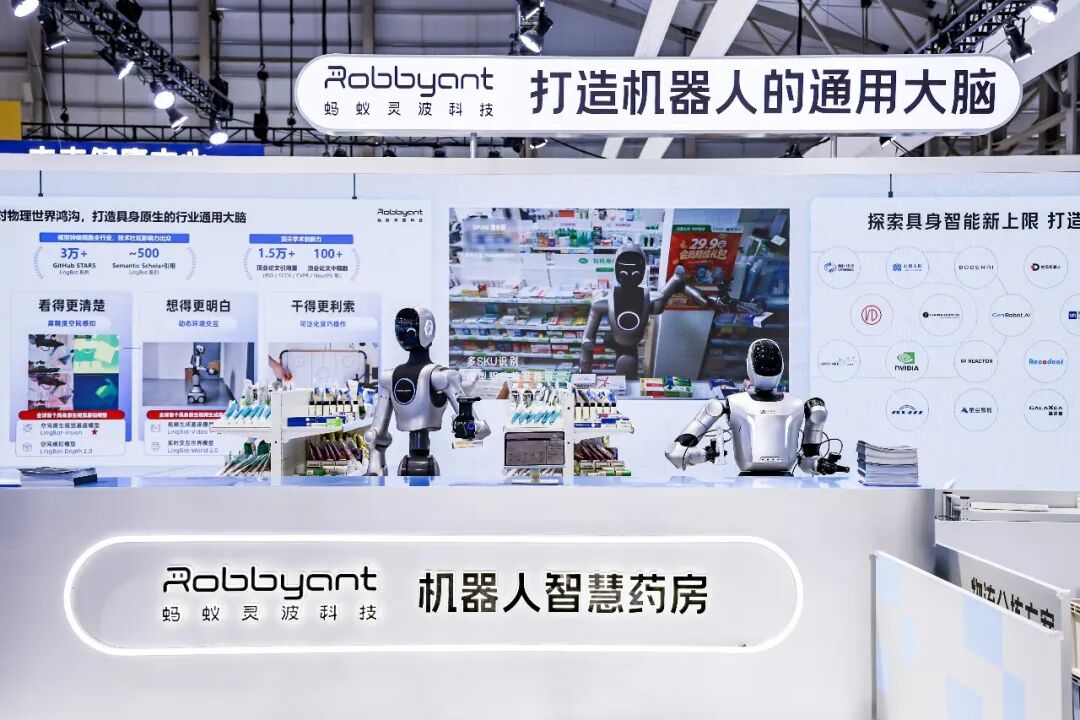
螞蟻靈波聯合國大藥房打造的智慧藥房,已在國大藥房上海門店投入運營
靈波目前押注的,是持續訓練和迭代通用基座的能力。對樂聚這樣的廠商而言,採用基座與自主研發也並不矛盾——不必把整套預訓練體系從頭再建一遍,仍然可以圍繞自己的本體和場景,發展專有的模型能力。
第二層是數據。LingBot-VLA 2.0 用了 6 萬小時預訓練數據,但這個數字本身不是重點。對具身基模來說,預訓練的難點從來不只是把數據規模做大,還包括如何組織數據分佈、判斷哪些數據真正有效,以及讓模型持續從真實世界的反饋中修正訓練方向。
原因在於,物理世界裏的 OOD (分佈外泛化)幾乎是常態:光照、背景、物體和任務持續變化,本體本身還存在硬件誤差和運動誤差。螞蟻靈波科技首席數據科學家黃用韜在 WRC 2026 上表示,單純把 10 萬小時擴到 100 萬甚至 1000 萬小時,也不會自然解決泛化問題。
問題也因此逐漸從「有多少數據」,轉向「模型究竟需要什麼數據」。這要求模型公司掌握更深的數據 know-how:哪些場景和任務值得采集,什麼軌跡有效,哪些數據應該過濾,模型失敗之後又應該補充哪一類數據。
這也是為什麼螞蟻靈波很早便從採購成品數據轉向定製化採集。大規模用工和場景運營可以交給專業供應商,模型公司則重點掌握數據標準、採集 SOP、質量判斷、數據配方,以及模型向採集端回傳需求的能力。黃用韜把這套思路概括為「Feedback is all you need」。
螞蟻靈波已經搭出一套持續把物理數據轉化為模型能力的 Infra。朱興透露,原始數據進入模型訓練的數據漏斗可用率,也從早期約 15%提升到 90%以上。
對一個基座公司來說,這個數字比 6 萬小時更加重要。它意味着每一小時新採回來的數據,有多少能真正變成模型能力,這直接決定下一個場景的數據成本能不能降。
第三層是模型設計的原則。 沈宇軍覆盤過去一年時提到,行業早期存在一定的數字世界路徑依賴:VLA 藉助 VLM,WAM 藉助視頻生成,希望沿用已經成熟的數字模型能力。但機器人面對的是持續輸入的傳感器信號、視覺、空間和力等物理模態,以及最終必須實時執行的動作。
靈波把自己的研發原則稱為「具身原生」:從機器人在物理世界工作的要求出發,來設計數據、訓練目標和模型。距離估計是否準確,動作能否及時響應,換一種身體還能否完成任務,這些要求都需要在預訓練階段得到處理。
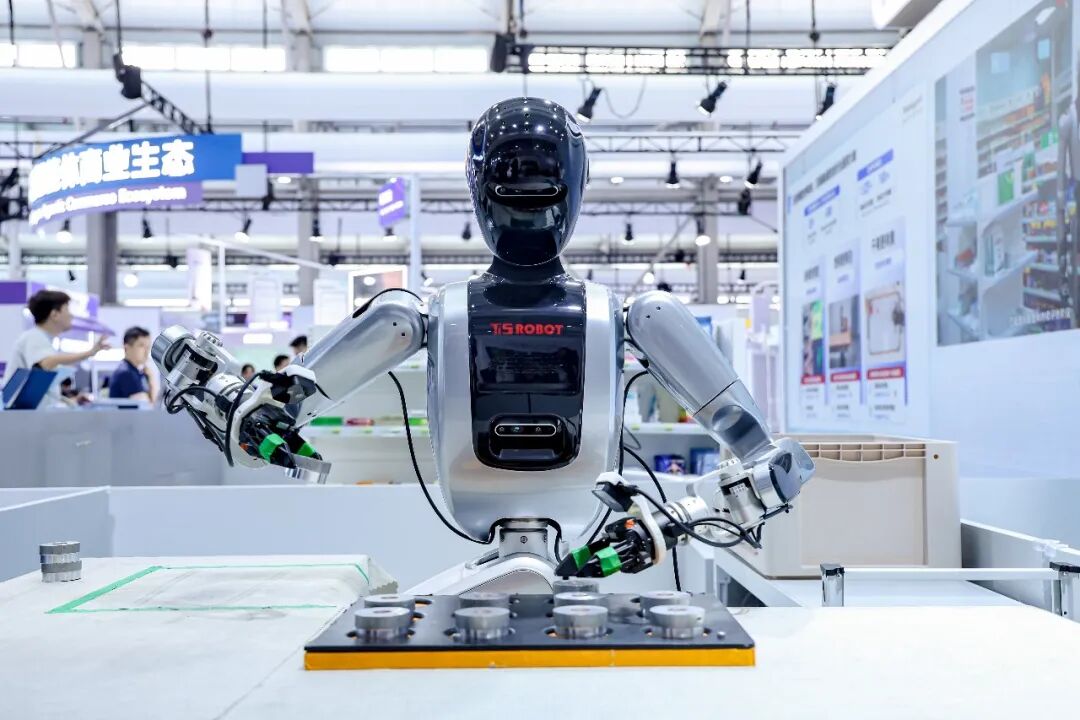
搭載螞蟻靈波通用大腦的鈦虎機器人完成工業上下料
機器人並沒有統一的「身體」。單臂、雙臂、靈巧手、腰、頭和移動底盤,在自由度和動作空間上都存在差異。LingBot-VLA 2.0 從預訓練階段便引入多構型數據,並通過統一動作空間、動作側 MoE 等設計,嘗試讓不同身體共享更多控制能力。對於希望承擔平台角色的大腦公司而言,這一點無法繞開。工業中的重載、分揀,以及未來家庭中的服務機器人,都可能採用完全不同的硬件形態。如果模型長期綁定單一本體,其複用範圍自然會受到限制。
靈波的全棧模型投入也有類似的考慮。空間感知不準,會影響抓取;無法預判環境的變化,動作規劃也會受限。Vision、Depth、VLA、World、VA、Zero-WAM 看上去屬於不同方向,但它們共享數據、訓練 Infra 和物理世界的研究經驗,並始終圍繞同一個核心問題展開:如何讓機器人更好地理解物理世界,並最終完成行動。
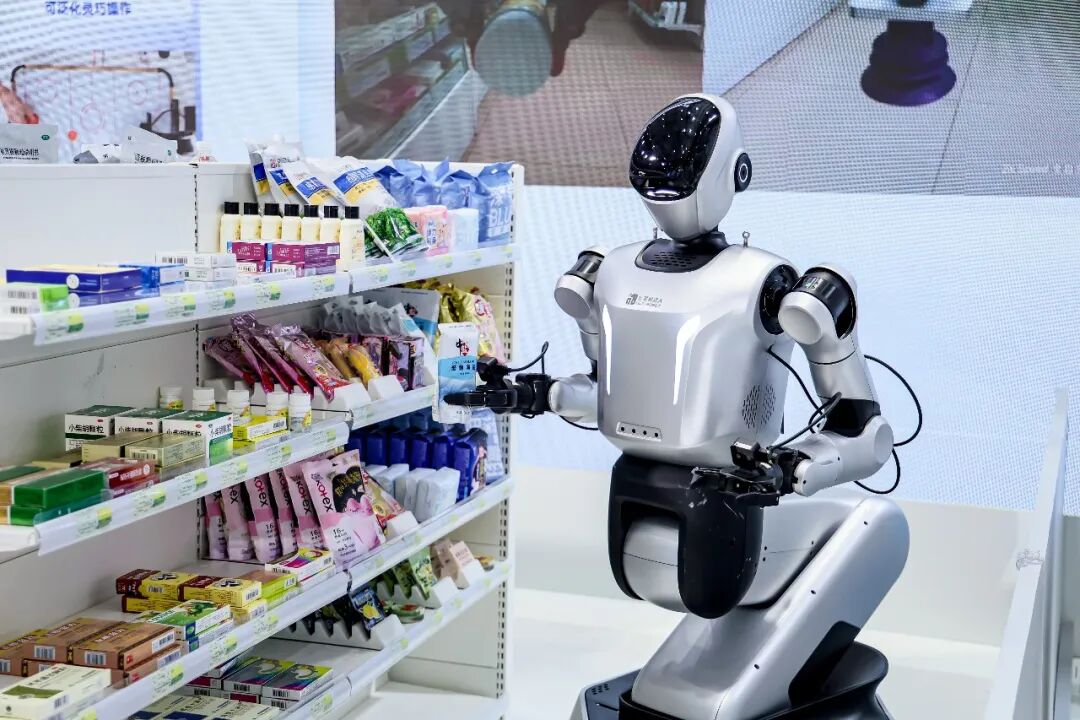
搭載螞蟻靈波通用大腦的樂聚機器人在零售藥房工作
朱興透露,靈波早期的 VA 曾基於通用視頻生成模型繼續訓練,但隨着研發深入逐漸碰到上限,隨後開始轉向大規模自主預訓練,並在空間感知、環境預測和可泛化靈巧操作上,都發布了面向具身智能的預訓練基模。
當然,平台能力最終仍然需要體系之外的驗證。LingBot-VLA 2.0 在 GM-100 雙臂平台上已經進入通用 VLA 的第一梯隊,而樂聚提供了一個更具體的產業樣本。
據樂聚披露,在 LingBot-VLA 2.0 完成 KUAVO 基礎遷移後,樂聚加入 600 多小時真機數據二次訓練,成功率從 16.27%提升至 48.27%,過程分從 42.06%提升至 74.51%;新技能僅需約 5 小時示範數據便可達到約 80%的成功率,整體訓練成本下降超過一半。
這些數字至少說明了一種可能的分工方式:通用基座先提供更高的能力起點,本體廠再利用自己的數據、場景和工程能力完成垂域適配。
沈宇軍也給出過更產業化的評價標準:下一代基模發布後,合作伙伴完成同一個場景所需要的數據、時間和落地成本,能否繼續下降。相比單純看 benchmark,這可能更接近平台型基模在產業中的實際價值。
到這裏,樂聚為什麼選擇 LingBot,也就有了一個相對清晰的解釋:它可以把投入最重、周期最長的通用預訓練交給基座,同時把更多資源集中在本體、客戶和垂域能力上。
而當鏡頭繼續拉遠,奧比中光、Reactor、國大藥房又分別從傳感器、開發者和終端場景接入,圍繞 LingBot 的合作開始延伸到產業鏈的不同環節。
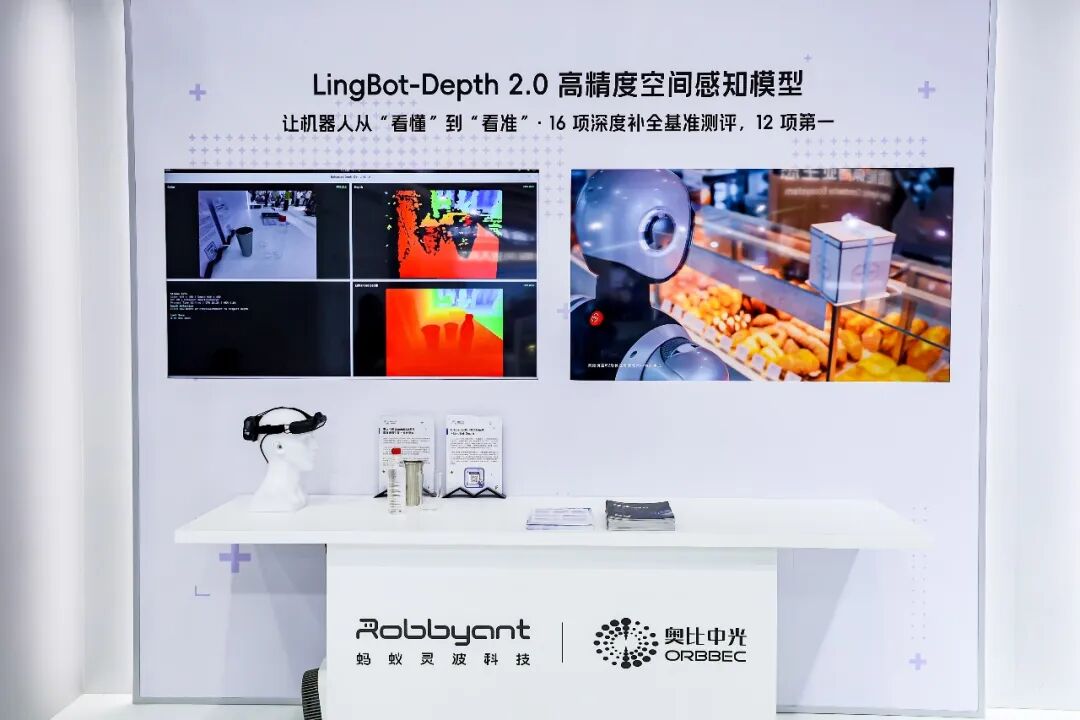
至此,已經能看到靈波幾張逐漸成形的牌:作為底座的數據管線與 Infra,作為核心的大規模預訓練,作為設計原則的具身原生,以及作為最終檢驗的外部採用。
近期的獨立孖展,正開始把這套平台化路線推向新的階段。
孖展攤開,路線圖浮出水面
前面的幾張牌,回答了螞蟻靈波已經積累了什麼。獨立孖展之後,更值得觀察的,是這些能力接下來如何被放大。
在 CEO 溝通會上,朱興專門回應了孖展動機:一是核心 AI 人才的市場化激勵,二是公司治理。具身智能需要長期投入、穿越多個產業周期,更獨立的治理結構,也讓靈波擁有了更清晰的公司邊界。
這條邊界進一步明確了它在產業鏈中的位置。朱興表示,靈波會繼續聚焦智能中心和通用大腦,對外核心輸出基座模型和工具鏈——覆蓋後訓練、數據處理、端側部署、真機強化學習等環節,再由本體廠和解決方案商結合具體機器人與客戶場景完成適配。樂聚已經呈現出這套分工的雛形。數據服務商、傳感器廠商、芯片廠商和場景客戶則從不同環節加入。
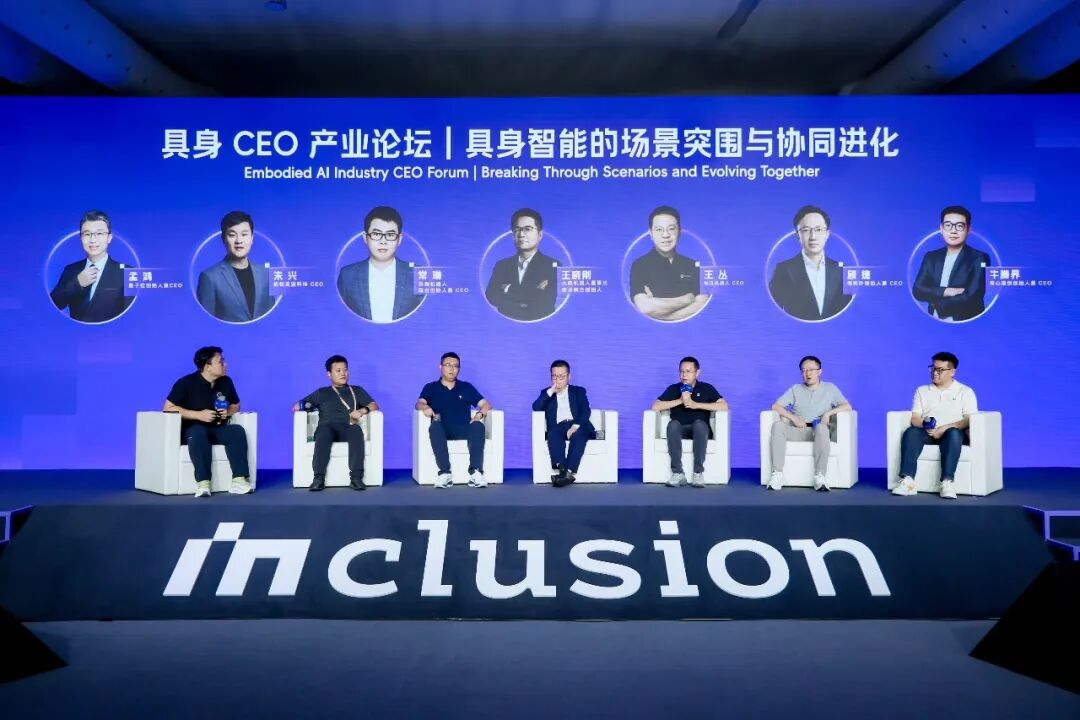
內部保留的 R 系列機器人,定位不是與本體廠競爭,主要服務模型研發和生活服務等前沿場景探索——朱興把它定義為「2B2C」的前哨:在機器人進入家庭之前,先在與人有接觸的生活服務場所,完成技術和商業的早期驗證。
朱興對商業化也保持着一定剋制。過早投入大量定製項目容易消耗基座研發資源,真實付費客戶和商業場景又不可缺少,它們能夠把模型放進更嚴格的環境中,讓異常和失敗重新回到訓練體系。
商業化由此成為模型迭代的一部分。基模進入更多本體,經過後訓練走向真實場景,再讓場景中的反饋回到模型。如果這套循環逐漸擴大,靈波連接的將是一張由本體、數據和場景共同構成的反饋網絡。
朱興給明年定了兩個可檢驗的指標:模型驅動的機器人真實幹活的數量,以及相同場景任務下後訓練數據成本的「指數級下降」。這兩個指標能不能兌現,是這套平台敘事下一次接受檢驗的時間點。
結語
日本傳統紙牌遊戲花札裏,有一種玩法叫 Koi-Koi。
當手裏的牌湊成一副有效牌型,玩家可以就此結束這一局、落袋為安,也可以喊一句「Koi-Koi」——繼續摸牌,去爭取一個更大的組合。
某種程度上,今天的螞蟻靈波正站在同一個位置上。沿着五個槓桿看,它的牌相對齊全:大規模自主預訓練,一套可用率從 15% 走到 90% 的數據管線,從預訓練階段就面向多構型的模型設計,正在鋪開的工具鏈,以及從樂聚、國大藥房開始的外部採用。
更重要的是,這些牌正在開始彼此組合。獨立孖展,又把它推向了一張更大的牌桌。
如果把具身智能看作一場啱啱開始的長牌局,此刻的螞蟻靈波顯然剛開始出牌。
它沒有停下計分,而是喊了一句「Koi-Koi」。
而平台型公司的想象力,正在於這些尚未完成的組合:接入的身體越多,進入的場景越廣,沉澱的數據越豐富,基礎模型也就越有機會繼續向前演化,再去觸及此前無法觸及的身體和場景。
下一張牌的價值,未必只在它自身。它也可能讓此前握在手裏的每一張牌,都多出一種可能的組合。
螞蟻靈波選擇繼續摸牌。
特別策劃