AI存儲進入全流程競爭。
作者 | 楊京麗
編輯 | 李水青
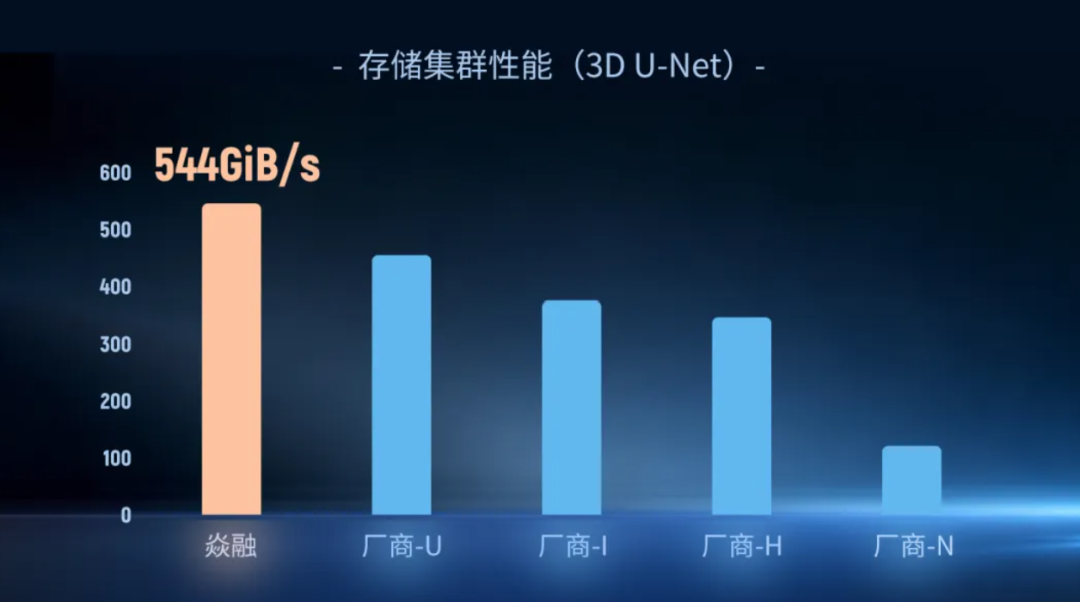
智東西9月17日報道,9月1日,全球權威AI性能評測組織MLCommons發布MLPerf Storage v3.0基準測試排行榜。焱融全閃AI存儲F9000X在多項基準測試中拿下第一,充分驗證其在極限AI訓練負載下對高速網絡帶寬的高效利用能力。
▲數據引用:MLPerf Storage Benchmark v3.0 Suite Results 2026
隨着AI產業從模型訓練走向規模化推理,存儲系統需要處理的數據和承擔的任務也在增加。訓練階段,存儲要持續向GPU供給海量數據,還要快速保存和恢復模型 Checkpoint;推理階段,系統又要管理不斷膨脹的KV Cache。單一的高性能存儲產品已經難以覆蓋AI全流程需求。
圍繞AI的訓練與推理場景,焱融已經構建起一套較為完整的全棧AI存儲方案。F9000X的測試成績充分驗證其訓練側能力:本次MLPerf Storage v3.0新增KVCache測試用例,進一步擴展了其對AI全場景工作負載的覆蓋能力。
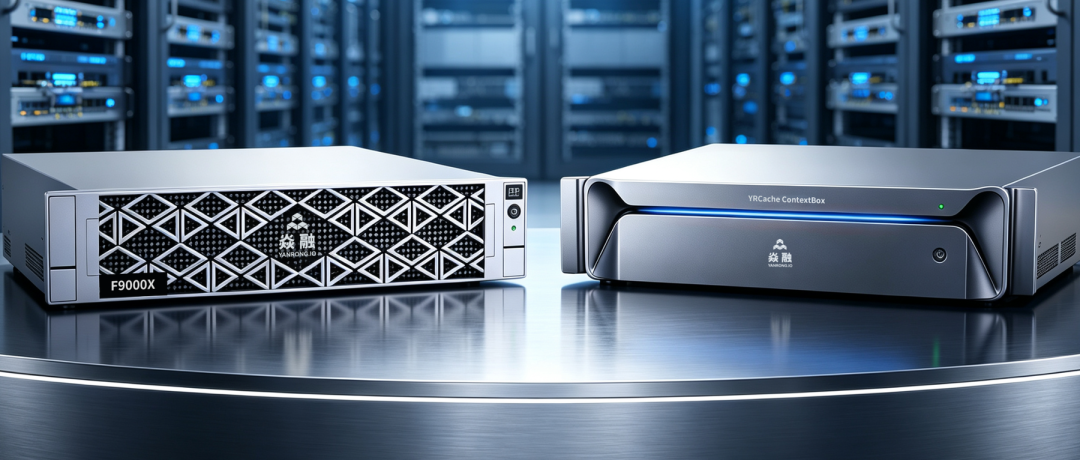
焱融科技近期推出的YRCache ContextBox一體機,就是面向AI推理場景的專屬KV Cache存儲產品,也是其全棧AI存儲能力在KV Cache管理、共享與複用方向的進一步落地。
從訓練數據的高速讀寫,到推理上下文的共享與複用,焱融是如何應對AI不同階段的存儲需求?這套全棧AI存儲方案又能為企業帶來怎樣的性能和成本價值?本文對此進行了深入解讀。
01.
三節點帶寬刷新紀錄
保證高效讀寫效率
大模型訓練需要持續從存儲系統讀取數據。隨着參與訓練的GPU數量增加,存儲系統需要同時為更多計算節點供給數據。如果數據吞吐能力不足,GPU可能因等待數據而降低利用率。訓練過程中還需要定期寫入Checkpoint,其讀寫性能會直接影響模型狀態的保存和訓練中斷後的恢復耗時。
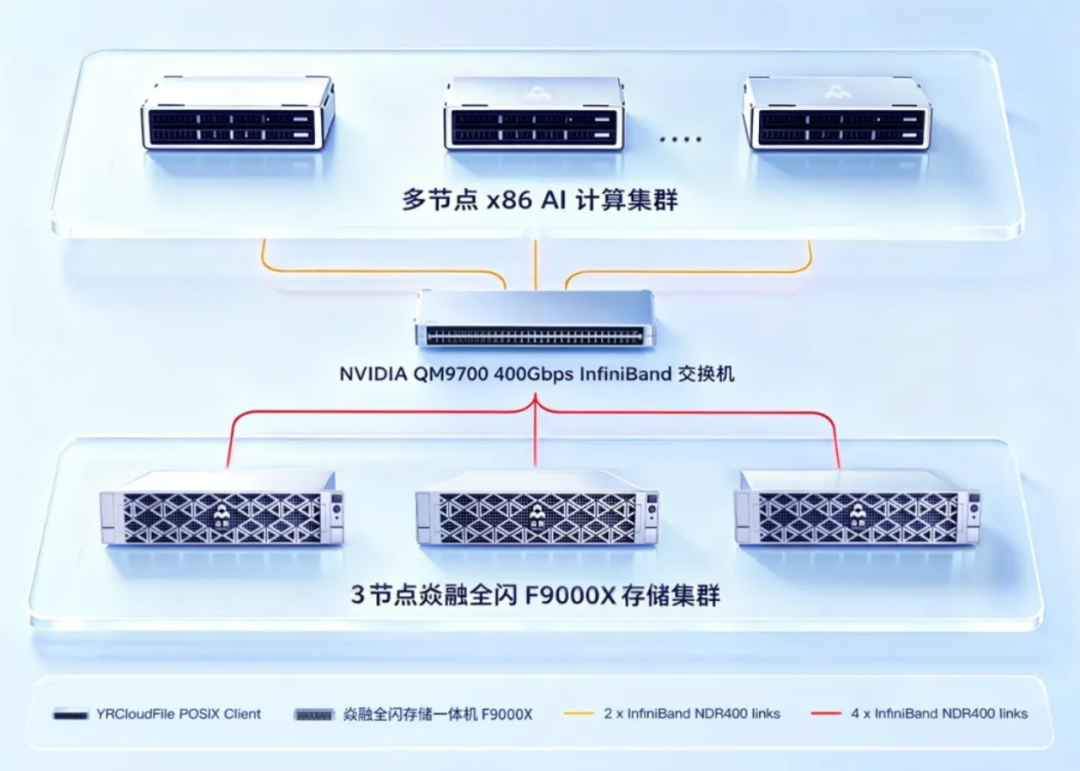
焱融F9000X是面向大規模AI訓練推出的全閃存儲產品,其訓練側實力可以從MLPerf Storage基準測試中得到驗證。測試環境包括3台F9000X存儲節點和9台x86客戶端服務器,節點通過NDR400高速網絡互聯。
3D U-Net模型訓練測試對存儲系統的持續帶寬輸出能力和極限負載穩定性,提出了較高要求。測試中,F9000X三節點集群實現544GiB/s聚合帶寬,位列該場景第一,達到了歷屆公開測試成績中的最高水平。相比此前v2.0測試的478GiB/s,其聚合帶寬進一步提升,表明存儲系統能夠更高效地向GPU提供訓練數據。
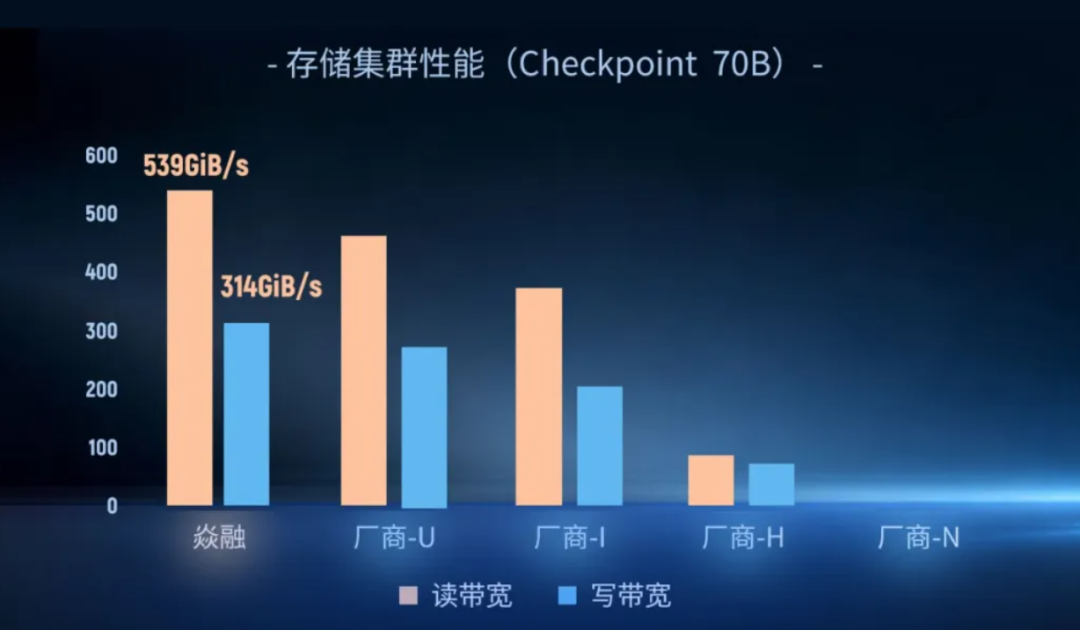
在Checkpoint 70B測試中,焱融存儲集群實現539GiB/s的讀帶寬和314GiB/s的寫帶寬,讀寫性能均位居第一,刷新曆屆MLPerf Storage公開測試成績。對於千億級、萬億級模型訓練,Checkpoint是保存階段性訓練狀態的關鍵數據。更快的讀寫速度,可以縮短模型存檔和恢復耗時,降低訓練中斷造成的算力浪費。
▲數據引用:MLPerf Storage Benchmark v3.0 Suite Results 2026
對企業而言,焱融F9000X更高的帶寬表現不僅能夠加快訓練數據讀寫,也有望在滿足同等訓練需求的情況下減少存儲節點投入,從而降低整體硬件投入成本。
02.
AI進入推理階段
存儲開始管理模型上下文
隨着AI進入推理階段,存儲系統關注的重點轉向模型上下文的管理與複用。長文本、多輪對話和Agent應用會產生大量KV Cache,如果這些緩存無法被保存和複用,模型就需要反覆計算相同的上下文。與此同時,推理請求的上下文更長、併發更高,KV Cache需要在不同節點之間共享、遷移和複用。
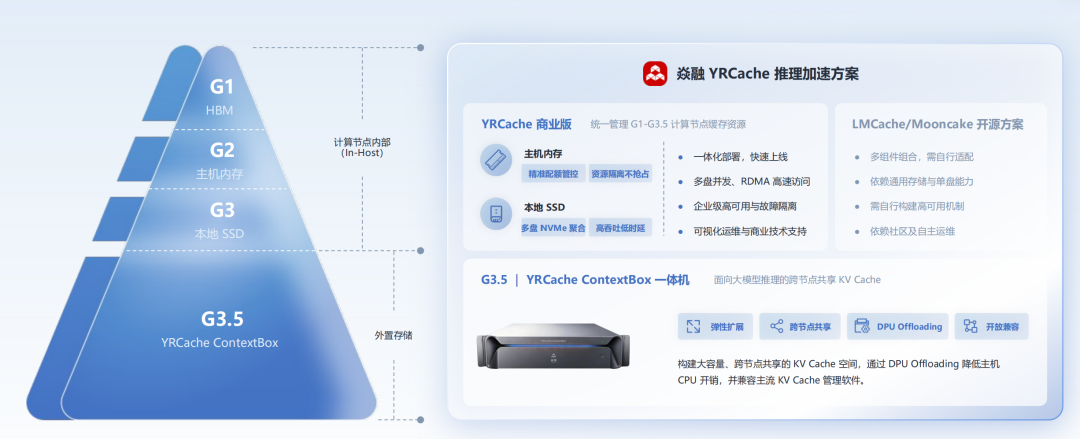
針對這一問題,焱融推出AI原生推理存儲系統YRCache,對不同層級的KV Cache資源進行統一管理,並將部分緩存從GPU顯存卸載至主機內存和本地SSD,減少重複計算。
在YRCache的多級緩存架構中,G1是GPU HBM,負責保存當前最活躍、訪問頻率最高的KV Cache;G2是主機DRAM,用於承接暫時無法放入GPU顯存的緩存;G3是本地SSD,容量更大、單位成本更低,適合保存單節點中的更多緩存;G4則是傳統共享分佈式存儲,主要承載模型、數據集和Checkpoint等需要長期保存的數據。
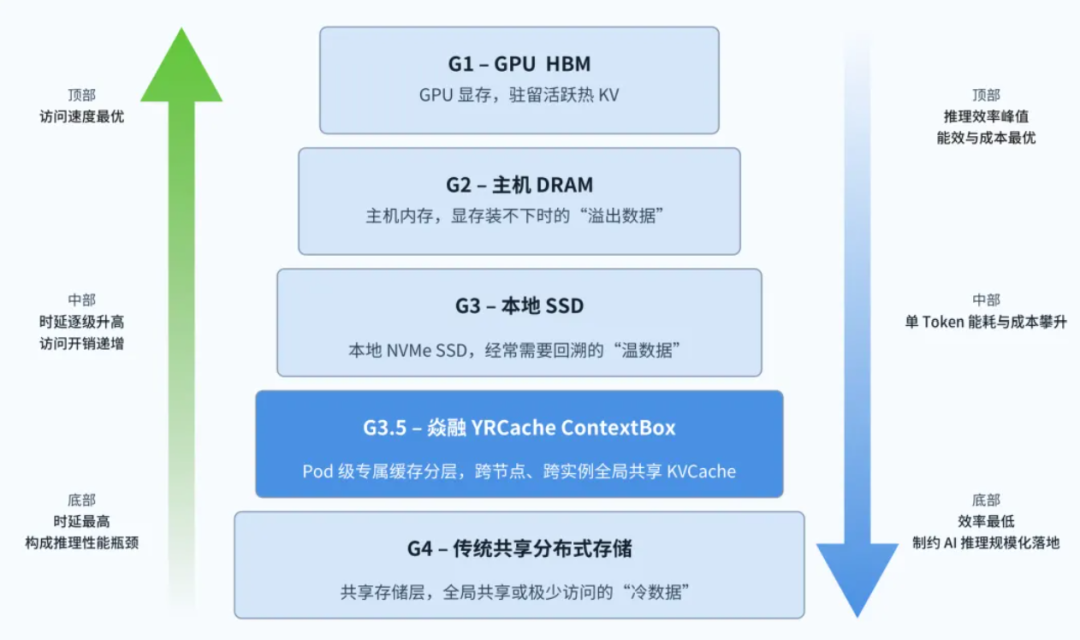
隨着推理集群擴大,本地SSD與傳統共享存儲之間出現了新的能力空檔。參考英偉達CMX架構對G3.5 Context Memory的設計,焱融在YRCache體系中引入了G3.5共享緩存層,並推出YRCache ContextBox一體機,面向長上下文、多輪對話和Agent推理提供跨節點共享的KV Cache空間,在靠近計算的同時支持緩存共享、複用和獨立擴展。
03.
補上共享緩存層
KV Cache實現跨節點複用
YRCache ContextBox面向G3.5共享緩存層設計,將計算、網絡、存儲和軟件協同起來,為推理集群提供獨立的共享KV Cache空間。焱融科技稱,ContextBox單台實測帶寬達120GB/s,可支持8個推理節點併發接入,緩存容量可擴展至PB級。
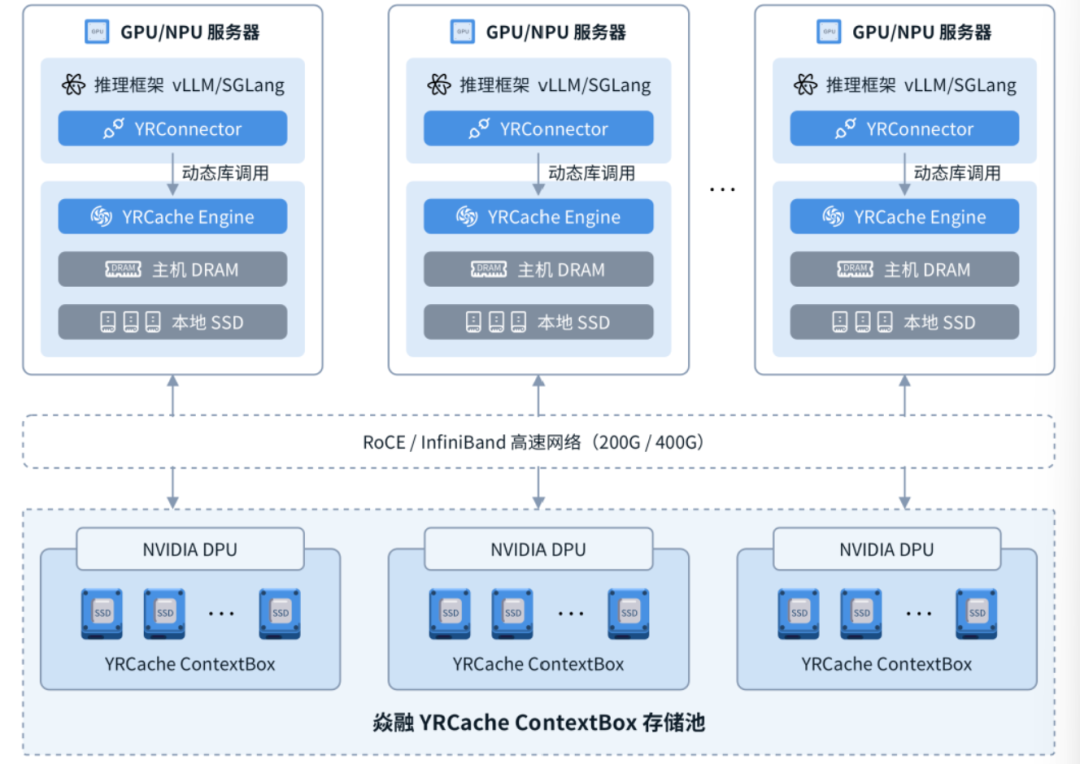
YRCache ContextBox首先讓不同推理節點能夠共享已經生成的KV Cache。請求即使被調度到另一台服務器,也不必重新計算相同的上下文。與此同時,緩存不再受單台服務器的顯存、內存和SSD容量限制,企業可以單獨擴展緩存空間;即使計算節點增減,已經保存的緩存也不會隨之丟失。
據焱融科技介紹,在某頭部AI企業測試中,8張NVIDIA H20-3e GPU運行SGLang和GLM-5.1,輸入上下文為31K至129K時,接入ContextBox後首Token時延降低89%至94%,Token吞吐提升3至6倍。
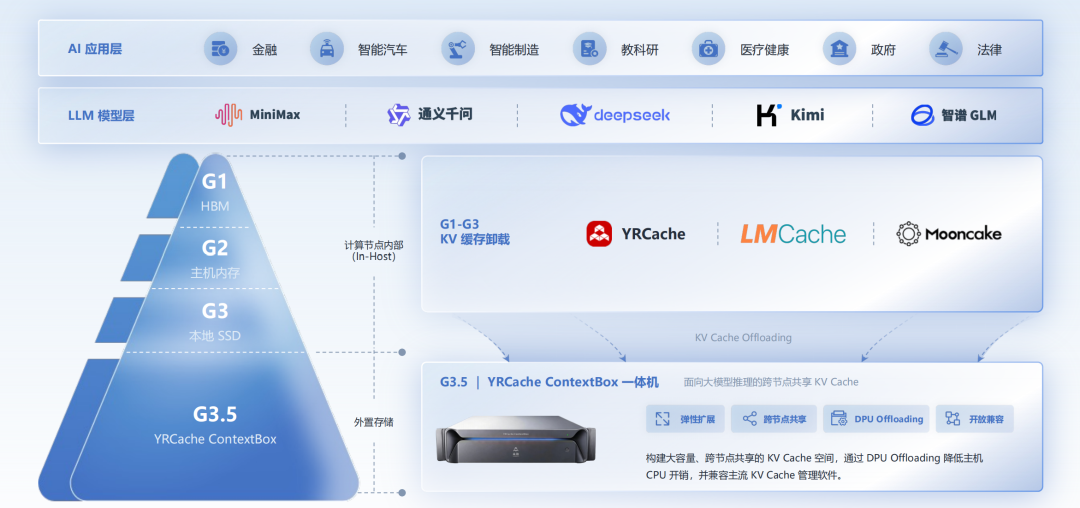
ContextBox還兼容YRCache、LMCache、Mooncake等管理軟件,為長上下文、多輪對話和Agent推理提供共享、可擴展的上下文基礎設施。
04.
從訓練到推理
AI存儲還要算效率和成本賬
作為國內較早、較完整面向AI全流程構建全棧AI存儲能力的廠商之一,焱融已形成覆蓋AI訓練與推理的存儲方案,以F9000X、YRCache推理存儲系統和YRCache ContextBox一體機為代表,覆蓋訓練數據讀取、模型狀態保存以及KV Cache管理等關鍵環節。
這套佈局對應了AI應用的不同階段:訓練時,F9000X提升數據和Checkpoint的讀寫效率,減少GPU等待;推理時,YRCache和YR Cache ContextBox管理、共享並複用KV Cache,減少重複計算。
對企業而言,這套方案的價值不只是提升帶寬或降低時延,更在於讓現有算力基礎設施承載更多訓練任務和推理請求。存儲效率提高後,企業不必只依靠增加GPU或存儲節點來擴大AI服務能力。
性能之外,成本也是AI基礎設施建設的重要考量。焱融科技稱,其單位性能硬件成本較行業市場平均水平降低約35%,同時Token效能提升120%。在提升AI存儲效率的同時,能夠更好地控制基礎設施投入。
從訓練數據供給,到模型狀態保存,再到推理上下文複用,焱融試圖用一套覆蓋全流程的存儲方案,減少算力等待和資源浪費,讓企業已經投入的GPU、網絡和存儲設備發揮更大價值。
05.
結語:從高吞吐到高複用
AI存儲進入全流程競爭
當AI競爭進入規模化應用階段,存儲不再只是後台的數據底座,而成為影響GPU利用率、推理效率和建設成本的關鍵基礎設施;焱融通過覆蓋訓練與推理場景的全棧AI存儲方案,幫助企業把算力和基礎設施投入用得更充分。
隨着模型規模、上下文長度和併發請求繼續增加,AI存儲的競爭也將從單一的峯值性能,轉向對不同數據、不同層級和不同使用周期的協同管理。AI基礎設施的建設越來越需要以更可控的成本承載更多訓練任務和推理請求。